Mensajes recientes
#91
QA (Quality Assurance) / QA, QC y Tester: por que no so...
Último mensaje por ANTRAX - Septiembre 13, 2026, 06:26:50 PMQA, QC y Tester: por qué no son sinónimos (y por qué confundirlos sale caro)
Buenas gente de Underc0de. Hay una pregunta que aparece una y otra vez en esta sección, en entrevistas de trabajo y en discusiones de equipo: ¿cuál es la diferencia entre QA, QC y Tester? La mayoría de las respuestas que circulan son del estilo "es lo mismo, depende de la empresa". Y no, no es lo mismo. Son tres cosas de naturaleza distinta: una es un proceso, otra es una actividad, y la tercera es un rol. Meterlas en la misma bolsa no es un problema de vocabulario: es lo que hace que equipos enteros terminen midiendo mal, contratando mal y arreglando bugs en el peor momento posible.
En este post voy a separar los tres conceptos, mostrar de dónde vienen, dónde encaja cada uno en el ciclo de vida del software, y qué significan en la práctica con ejemplos de código. Al final dejo una tabla comparativa y algunos mitos que conviene desarmar.
1. El origen de la confusión
La confusión tiene una explicación histórica concreta. Los términos Quality Assurance y Quality Control no nacieron en el software: vienen de la industria manufacturera de mediados del siglo XX, del mundo de Deming, Juran e Ishikawa. Cuando la industria del software empezó a profesionalizarse en los 80 y 90, tomó prestado el vocabulario de las fábricas sin adaptarlo del todo.
A eso se le sumó un fenómeno muy argentino —y muy global también—: el mercado laboral usa "QA" como título genérico para cualquiera que se dedique a probar software. Vas a ver avisos que dicen "Se busca QA Manual Semi Senior" cuando en realidad lo que buscan es un tester. El título del puesto dice una cosa, las tareas dicen otra.
La norma ISO 9000 define ambos términos de forma bastante clara:
Leelo dos veces, porque toda la diferencia está ahí. QA genera confianza en el proceso. QC verifica el resultado. Uno mira el cómo, el otro mira el qué.
2. QA — Quality Assurance: el proceso
QA es preventivo y está orientado al proceso. Su pregunta de fondo no es "¿este build tiene bugs?" sino "¿por qué nuestro proceso permite que este tipo de bug llegue hasta acá?".
Un QA de verdad no se sienta a ejecutar casos de prueba todo el día. Se dedica a cosas como:
La herramienta conceptual clásica de QA es el ciclo PDCA (Plan-Do-Check-Act), también conocido como ciclo de Deming. Es la lógica de mejora continua: planificás un cambio, lo implementás, medís el resultado y ajustás.

Un ejemplo concreto de mentalidad QA. Supongamos que en los últimos tres sprints se escaparon a producción cinco bugs de validación de formularios. La reacción QC sería: "agreguemos más casos de prueba para formularios". La reacción QA es distinta:
La primera respuesta agrega trabajo para siempre. La segunda elimina la clase entera de problema. Esa es la diferencia.
3. QC — Quality Control: el producto
QC es detectivo (en el sentido de "detecta", no de Sherlock) y está orientado al producto. Trabaja sobre algo que ya existe: un build, una release candidate, un endpoint desplegado. Su pregunta es "¿esto cumple con lo que se especificó?".
Actividades típicas de QC:
Acá es donde vive la famosa pirámide de testing: la idea de que deberías tener muchas pruebas unitarias (rápidas y baratas), una cantidad moderada de pruebas de integración, y pocas pruebas end-to-end (lentas y frágiles).

Ojo con un matiz importante: la pirámide es una herramienta de QC en su ejecución, pero decidir la forma de esa pirámide para tu proyecto es una decisión de QA. Alguien tiene que definir la estrategia; otro alguien la ejecuta. A veces son la misma persona con dos sombreros distintos, y ahí es donde se mezcla todo.
4. Tester: el rol, no el proceso
Y acá viene la parte que más se malinterpreta. Tester no es un tercer proceso. QA y QC son procesos o conjuntos de actividades. Tester es una persona, un rol dentro del equipo.
Dicho de otra forma: un tester es quien ejecuta principalmente actividades de QC. Es el rol humano que se sienta a diseñar casos de prueba, ejecutarlos, encontrar defectos y reportarlos.
Comparar "QA vs QC vs Tester" es técnicamente una comparación mal formada, como preguntar "¿cuál es la diferencia entre cocina, cocinar y cocinero?". Pero la pregunta se hace igual porque en el mercado los tres términos se usan como si fueran títulos de puesto intercambiables. Así que vale la pena responderla en sus propios términos.
Un buen tester, además, hace algo que ninguna automatización reemplaza: testing exploratorio. Es decir, usar criterio, intuición y conocimiento del dominio para encontrar problemas que nadie especificó. Un script automatizado sólo encuentra lo que le dijiste que busque. Un tester con experiencia encuentra lo que a nadie se le ocurrió preguntar.
5. La analogía del restaurante
Esta es la forma más rápida que conozco de explicarlo en una entrevista:
Si tu único mecanismo de calidad es probar los platos al final, vas a devolver muchos platos a la cocina. Vas a tener un proceso de mala calidad con un control muy activo. Funciona, pero es carísimo, lento y agota a la gente. Ese es exactamente el estado de muchos equipos de software que dicen "tenemos QA" cuando lo que tienen es QC sobrecargado.
6. Dónde encaja cada uno en el ciclo de vida
El modelo en V muestra bien esta relación. La rama izquierda baja por las fases de definición y diseño; la derecha sube por las fases de verificación. Cada nivel de la izquierda tiene su contraparte de prueba a la derecha.

Leído en clave QA/QC:
Esto conecta con un principio que todo el mundo cita y poca gente aplica: el costo de corregir un defecto crece de forma no lineal según la etapa en que se detecta. Un malentendido de requisitos corregido en refinamiento cuesta una charla de diez minutos. El mismo malentendido detectado en producción cuesta un hotfix, una comunicación a clientes, posible pérdida de datos y horas de varias personas.
7. Cómo se ve en el código
Hasta acá suena abstracto, así que bajémoslo a archivos concretos. Veamos el mismo requisito atravesando los tres niveles.
QA define el criterio de aceptación (antes de que exista una línea de código). Esto es un artefacto de proceso, no una prueba:
Código: gherkin
QC ejecuta la verificación. Acá ya hay código corriendo contra un producto que existe:
Código: python
QA diseña el proceso que hace obligatoria esa verificación. Este pipeline no prueba el producto: prueba que el equipo no pueda saltearse los controles. Es prevención pura:
Código: yaml
Notá la diferencia de naturaleza. El archivo de pytest responde "¿funciona?". El archivo de CI responde "¿podemos garantizar que nadie mergee sin que alguien haya preguntado si funciona?". Son preguntas de niveles distintos.
Y una métrica que un QA debería mirar, que no sale de ejecutar pruebas sino de analizar el historial:
Código: sql
8. Tabla comparativa
Regla mnemotécnica: QA = proceso, QC = producto, Tester = persona.
9. Mitos que conviene desarmar
"QA es el que rompe el software." No. Nadie rompe nada: el defecto ya estaba ahí. QC lo encuentra. Y QA idealmente hace que no llegue a existir.
"Si automatizamos todo, no necesitamos testers." La automatización es QC ejecutado por una máquina. Cubre regresión, que es repetitiva y aburrida, y lo hace excelente. Pero no hace testing exploratorio, no cuestiona requisitos y no tiene criterio sobre el negocio. Automatizás lo conocido; el tester busca lo desconocido.
"QA es responsabilidad del equipo de QA." Este es el más caro de todos. Si la calidad es "de QA", el resto del equipo delega y el área se convierte en un cuello de botella al final del sprint. QA como proceso es responsabilidad de todos: el dev que escribe unitarias está haciendo QC, y el que participa en definir el DoD está haciendo QA.
"Somos ágiles, no necesitamos procesos." Ágil no significa ausencia de proceso, significa proceso liviano y adaptable. El Definition of Done es un artefacto de QA. La retrospectiva es literalmente el "Act" del ciclo PDCA.
"QA es el escalón para pasar a desarrollo." Es una carrera con su propia progresión: tester, analista de QA, automatizador, SDET, QA lead, arquitecto de calidad. Tratarlo como sala de espera es la mejor forma de que la gente buena se vaya.
10. Cómo saber qué estás haciendo realmente
Un ejercicio honesto. Mirá tu última semana de trabajo y clasificá en qué se fue el tiempo:
Si el 95% cae en la primera lista pero tu título dice "QA Engineer", no está mal necesariamente —es la realidad de buena parte de la industria— pero vale saberlo. Y si querés moverte hacia QA real, el camino no es aprender otra herramienta de automatización: es empezar a meterte antes en el ciclo. Pedí participar en los refinamientos. Cuestioná un requisito ambiguo antes de que se desarrolle. La próxima vez que se escape un bug, en vez de solo agregar un caso de prueba, preguntá por qué se escapó y proponé un cambio de proceso.
Cierre
Resumiendo: QA es un proceso preventivo orientado a cómo se construye. QC es un conjunto de actividades detectivas orientadas a lo construido. Tester es el rol que ejecuta principalmente QC. No compiten entre sí y no son intercambiables: se necesitan mutuamente. QC sin QA es apagar incendios para siempre. QA sin QC es confiar en el proceso sin verificar nada.
Y un equipo maduro no elige entre uno y otro: usa QC para medir si su QA está funcionando. Si el escape rate baja sprint a sprint, tu proceso está mejorando. Si sube, no importa cuántos casos de prueba agregues, el problema está más arriba.
Abro el debate, que acá hay gente con experiencia real en el tema:
Nos leemos.
Créditos de las imágenes: diagramas de Wikimedia Commons — You are not allowed to view links. You are not allowed to view links. Register or Login or You are not allowed to view links. Register or Login, You are not allowed to view links. You are not allowed to view links. Register or Login or You are not allowed to view links. Register or Login y You are not allowed to view links. You are not allowed to view links. Register or Login or You are not allowed to view links. Register or Login (CC BY-SA / GFDL).
Saludos,
ANTRAX
Buenas gente de Underc0de. Hay una pregunta que aparece una y otra vez en esta sección, en entrevistas de trabajo y en discusiones de equipo: ¿cuál es la diferencia entre QA, QC y Tester? La mayoría de las respuestas que circulan son del estilo "es lo mismo, depende de la empresa". Y no, no es lo mismo. Son tres cosas de naturaleza distinta: una es un proceso, otra es una actividad, y la tercera es un rol. Meterlas en la misma bolsa no es un problema de vocabulario: es lo que hace que equipos enteros terminen midiendo mal, contratando mal y arreglando bugs en el peor momento posible.
En este post voy a separar los tres conceptos, mostrar de dónde vienen, dónde encaja cada uno en el ciclo de vida del software, y qué significan en la práctica con ejemplos de código. Al final dejo una tabla comparativa y algunos mitos que conviene desarmar.
1. El origen de la confusión
La confusión tiene una explicación histórica concreta. Los términos Quality Assurance y Quality Control no nacieron en el software: vienen de la industria manufacturera de mediados del siglo XX, del mundo de Deming, Juran e Ishikawa. Cuando la industria del software empezó a profesionalizarse en los 80 y 90, tomó prestado el vocabulario de las fábricas sin adaptarlo del todo.
A eso se le sumó un fenómeno muy argentino —y muy global también—: el mercado laboral usa "QA" como título genérico para cualquiera que se dedique a probar software. Vas a ver avisos que dicen "Se busca QA Manual Semi Senior" cuando en realidad lo que buscan es un tester. El título del puesto dice una cosa, las tareas dicen otra.
La norma ISO 9000 define ambos términos de forma bastante clara:
CitarAseguramiento de la calidad (QA): parte de la gestión de la calidad orientada a proporcionar confianza en que se cumplirán los requisitos de la calidad.
Control de la calidad (QC): parte de la gestión de la calidad orientada al cumplimiento de los requisitos de la calidad.
Leelo dos veces, porque toda la diferencia está ahí. QA genera confianza en el proceso. QC verifica el resultado. Uno mira el cómo, el otro mira el qué.
2. QA — Quality Assurance: el proceso
QA es preventivo y está orientado al proceso. Su pregunta de fondo no es "¿este build tiene bugs?" sino "¿por qué nuestro proceso permite que este tipo de bug llegue hasta acá?".
Un QA de verdad no se sienta a ejecutar casos de prueba todo el día. Se dedica a cosas como:
- Definir el Definition of Done y los criterios de aceptación junto con Producto y Desarrollo.
- Establecer estándares de código, convenciones de branching y políticas de revisión.
- Diseñar la estrategia de testing: qué se automatiza, qué se prueba a mano, qué se cubre en cada nivel.
- Definir métricas y hacer que signifiquen algo (escape rate, lead time, densidad de defectos por módulo).
- Correr análisis de causa raíz cuando algo se rompe en producción.
- Meter calidad en etapas tempranas: revisión de requisitos, refinamiento, diseño.
- Auditar que el proceso definido se esté cumpliendo de verdad y no solo en la documentación.
La herramienta conceptual clásica de QA es el ciclo PDCA (Plan-Do-Check-Act), también conocido como ciclo de Deming. Es la lógica de mejora continua: planificás un cambio, lo implementás, medís el resultado y ajustás.
Un ejemplo concreto de mentalidad QA. Supongamos que en los últimos tres sprints se escaparon a producción cinco bugs de validación de formularios. La reacción QC sería: "agreguemos más casos de prueba para formularios". La reacción QA es distinta:
Citar¿Por qué se escapan? Porque los criterios de aceptación de las historias no especifican el comportamiento ante entradas inválidas. ¿Por qué no lo especifican? Porque no tenemos una plantilla de historia que lo exija. Acción: incorporamos validaciones obligatorias al template de historia y agregamos un checkpoint en el refinamiento.
La primera respuesta agrega trabajo para siempre. La segunda elimina la clase entera de problema. Esa es la diferencia.
3. QC — Quality Control: el producto
QC es detectivo (en el sentido de "detecta", no de Sherlock) y está orientado al producto. Trabaja sobre algo que ya existe: un build, una release candidate, un endpoint desplegado. Su pregunta es "¿esto cumple con lo que se especificó?".
Actividades típicas de QC:
- Ejecutar casos de prueba, manuales o automatizados.
- Testing funcional, de regresión, de integración, de performance, de seguridad.
- Reportar y hacer seguimiento de defectos.
- Verificar que los criterios de aceptación se cumplan.
- Smoke testing post-deploy.
- Validar fixes y re-testear.
Acá es donde vive la famosa pirámide de testing: la idea de que deberías tener muchas pruebas unitarias (rápidas y baratas), una cantidad moderada de pruebas de integración, y pocas pruebas end-to-end (lentas y frágiles).
Ojo con un matiz importante: la pirámide es una herramienta de QC en su ejecución, pero decidir la forma de esa pirámide para tu proyecto es una decisión de QA. Alguien tiene que definir la estrategia; otro alguien la ejecuta. A veces son la misma persona con dos sombreros distintos, y ahí es donde se mezcla todo.
4. Tester: el rol, no el proceso
Y acá viene la parte que más se malinterpreta. Tester no es un tercer proceso. QA y QC son procesos o conjuntos de actividades. Tester es una persona, un rol dentro del equipo.
Dicho de otra forma: un tester es quien ejecuta principalmente actividades de QC. Es el rol humano que se sienta a diseñar casos de prueba, ejecutarlos, encontrar defectos y reportarlos.
Comparar "QA vs QC vs Tester" es técnicamente una comparación mal formada, como preguntar "¿cuál es la diferencia entre cocina, cocinar y cocinero?". Pero la pregunta se hace igual porque en el mercado los tres términos se usan como si fueran títulos de puesto intercambiables. Así que vale la pena responderla en sus propios términos.
Un buen tester, además, hace algo que ninguna automatización reemplaza: testing exploratorio. Es decir, usar criterio, intuición y conocimiento del dominio para encontrar problemas que nadie especificó. Un script automatizado sólo encuentra lo que le dijiste que busque. Un tester con experiencia encuentra lo que a nadie se le ocurrió preguntar.
5. La analogía del restaurante
Esta es la forma más rápida que conozco de explicarlo en una entrevista:
- QA es diseñar la cocina: definir las recetas estandarizadas, las temperaturas de conservación, los controles de proveedores, la capacitación del personal y los protocolos de higiene. Todo eso existe antes de que se cocine el primer plato, y su objetivo es que sea difícil cocinar mal.
- QC es probar el plato antes de que salga del pase. ¿Está a la temperatura correcta? ¿Tiene los ingredientes que dice el menú? ¿La presentación es la esperada?
- El tester es la persona que prueba el plato.
Si tu único mecanismo de calidad es probar los platos al final, vas a devolver muchos platos a la cocina. Vas a tener un proceso de mala calidad con un control muy activo. Funciona, pero es carísimo, lento y agota a la gente. Ese es exactamente el estado de muchos equipos de software que dicen "tenemos QA" cuando lo que tienen es QC sobrecargado.
6. Dónde encaja cada uno en el ciclo de vida
El modelo en V muestra bien esta relación. La rama izquierda baja por las fases de definición y diseño; la derecha sube por las fases de verificación. Cada nivel de la izquierda tiene su contraparte de prueba a la derecha.
Leído en clave QA/QC:
- Toda la rama izquierda (requisitos, arquitectura, diseño) es territorio de QA. Acá se previene. Un requisito ambiguo detectado en esta etapa cuesta una fracción de lo que cuesta el bug que genera.
- Toda la rama derecha (unitarias, integración, sistema, aceptación) es territorio de QC. Acá se detecta.
- Las líneas horizontales que conectan ambas ramas son la clave: cada actividad de verificación existe porque hay algo definido del otro lado que verificar. Si no definiste bien a la izquierda, no podés verificar bien a la derecha.
Esto conecta con un principio que todo el mundo cita y poca gente aplica: el costo de corregir un defecto crece de forma no lineal según la etapa en que se detecta. Un malentendido de requisitos corregido en refinamiento cuesta una charla de diez minutos. El mismo malentendido detectado en producción cuesta un hotfix, una comunicación a clientes, posible pérdida de datos y horas de varias personas.
7. Cómo se ve en el código
Hasta acá suena abstracto, así que bajémoslo a archivos concretos. Veamos el mismo requisito atravesando los tres niveles.
QA define el criterio de aceptación (antes de que exista una línea de código). Esto es un artefacto de proceso, no una prueba:
Feature: Validacion de contrasena en el registro

  # Criterio acordado en refinamiento entre Producto, Dev y QA.
  # Define QUE significa "correcto". No ejecuta nada todavia.

  Scenario Outline: Se rechazan contrasenas debiles
    Given un usuario en el formulario de registro
    When ingresa la contrasena "<password>"
    Then el sistema muestra el error "<mensaje>"
    And el boton de registro permanece deshabilitado

    Examples:
      | password      | mensaje                                  |
      | abc           | Minimo 8 caracteres                      |
      | abcdefgh      | Debe incluir al menos un numero          |
      | abcdefg1      | Debe incluir al menos una mayuscula      |
      | 12345678      | Debe incluir al menos una letra          |
QC ejecuta la verificación. Acá ya hay código corriendo contra un producto que existe:
import pytest
from app.validators import validar_password, PasswordError


@pytest.mark.parametrize("password,mensaje_esperado", [
    ("abc",      "Minimo 8 caracteres"),
    ("abcdefgh", "Debe incluir al menos un numero"),
    ("abcdefg1", "Debe incluir al menos una mayuscula"),
    ("12345678", "Debe incluir al menos una letra"),
])
def test_passwords_debiles_son_rechazadas(password, mensaje_esperado):
    """Verifica el producto contra el criterio definido por QA."""
    with pytest.raises(PasswordError) as excinfo:
        validar_password(password)
    assert str(excinfo.value) == mensaje_esperado


def test_password_valida_es_aceptada():
    assert validar_password("Underc0de2026") is True
QA diseña el proceso que hace obligatoria esa verificación. Este pipeline no prueba el producto: prueba que el equipo no pueda saltearse los controles. Es prevención pura:
name: quality-gate

on:
  pull_request:
    branches: [main]

jobs:
  gate:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4

      - name: Linter (estandar de codigo definido por QA)
        run: ruff check .

      - name: Tests unitarios con umbral de cobertura
        run: pytest --cov=app --cov-fail-under=80

      - name: Analisis estatico de seguridad
        run: bandit -r app/ -ll

      # La politica: sin estos checks en verde, el merge no ocurre.
      # Eso es aseguramiento, no control.
Notá la diferencia de naturaleza. El archivo de pytest responde "¿funciona?". El archivo de CI responde "¿podemos garantizar que nadie mergee sin que alguien haya preguntado si funciona?". Son preguntas de niveles distintos.
Y una métrica que un QA debería mirar, que no sale de ejecutar pruebas sino de analizar el historial:
-- Escape rate: defectos encontrados en produccion
-- sobre el total de defectos del periodo.
-- Si sube, el problema esta en el proceso, no en el ultimo build.

SELECT
    DATE_TRUNC('month', fecha_reporte)                       AS mes,
    COUNT(*) FILTER (WHERE entorno = 'produccion')           AS escapados,
    COUNT(*)                                                 AS total,
    ROUND(
        100.0 * COUNT(*) FILTER (WHERE entorno = 'produccion')
        / NULLIF(COUNT(*), 0)
    , 2)                                                     AS escape_rate_pct
FROM defectos
WHERE fecha_reporte >= NOW() - INTERVAL '12 months'
GROUP BY 1
ORDER BY 1;
8. Tabla comparativa
| Aspecto | QA | QC | Tester |
| Qué es | Proceso | Actividad / conjunto de técnicas | Rol / persona |
| Enfoque | Proceso | Producto | Producto |
| Naturaleza | Preventiva | Detectiva | Detectiva |
| Pregunta clave | ¿Estamos construyendo bien? | ¿Lo construido cumple? | ¿Dónde falla esto? |
| Momento | Durante todo el ciclo, sobre todo al inicio | Después de construir | Después de construir |
| Responsable | Todo el equipo | Equipo de testing | La persona en el rol |
| Ejemplo | Definir el Definition of Done | Ejecutar regresión | Diseñar y correr casos, explorar |
| Salida típica | Estándares, políticas, métricas | Reportes de defectos | Bugs, evidencia, feedback |
Regla mnemotécnica: QA = proceso, QC = producto, Tester = persona.
9. Mitos que conviene desarmar
"QA es el que rompe el software." No. Nadie rompe nada: el defecto ya estaba ahí. QC lo encuentra. Y QA idealmente hace que no llegue a existir.
"Si automatizamos todo, no necesitamos testers." La automatización es QC ejecutado por una máquina. Cubre regresión, que es repetitiva y aburrida, y lo hace excelente. Pero no hace testing exploratorio, no cuestiona requisitos y no tiene criterio sobre el negocio. Automatizás lo conocido; el tester busca lo desconocido.
"QA es responsabilidad del equipo de QA." Este es el más caro de todos. Si la calidad es "de QA", el resto del equipo delega y el área se convierte en un cuello de botella al final del sprint. QA como proceso es responsabilidad de todos: el dev que escribe unitarias está haciendo QC, y el que participa en definir el DoD está haciendo QA.
"Somos ágiles, no necesitamos procesos." Ágil no significa ausencia de proceso, significa proceso liviano y adaptable. El Definition of Done es un artefacto de QA. La retrospectiva es literalmente el "Act" del ciclo PDCA.
"QA es el escalón para pasar a desarrollo." Es una carrera con su propia progresión: tester, analista de QA, automatizador, SDET, QA lead, arquitecto de calidad. Tratarlo como sala de espera es la mejor forma de que la gente buena se vaya.
10. Cómo saber qué estás haciendo realmente
Un ejercicio honesto. Mirá tu última semana de trabajo y clasificá en qué se fue el tiempo:
- Ejecutar casos, reportar bugs, re-testear fixes → estás haciendo QC.
- Discutir criterios de aceptación, mejorar el pipeline, analizar por qué se escapó un bug, definir estándares → estás haciendo QA.
Si el 95% cae en la primera lista pero tu título dice "QA Engineer", no está mal necesariamente —es la realidad de buena parte de la industria— pero vale saberlo. Y si querés moverte hacia QA real, el camino no es aprender otra herramienta de automatización: es empezar a meterte antes en el ciclo. Pedí participar en los refinamientos. Cuestioná un requisito ambiguo antes de que se desarrolle. La próxima vez que se escape un bug, en vez de solo agregar un caso de prueba, preguntá por qué se escapó y proponé un cambio de proceso.
Cierre
Resumiendo: QA es un proceso preventivo orientado a cómo se construye. QC es un conjunto de actividades detectivas orientadas a lo construido. Tester es el rol que ejecuta principalmente QC. No compiten entre sí y no son intercambiables: se necesitan mutuamente. QC sin QA es apagar incendios para siempre. QA sin QC es confiar en el proceso sin verificar nada.
Y un equipo maduro no elige entre uno y otro: usa QC para medir si su QA está funcionando. Si el escape rate baja sprint a sprint, tu proceso está mejorando. Si sube, no importa cuántos casos de prueba agregues, el problema está más arriba.
Abro el debate, que acá hay gente con experiencia real en el tema:
- ¿En sus empresas el rol de QA hace QA de verdad o es QC con otro nombre?
- ¿Les tocó implementar algún cambio de proceso que haya bajado defectos de forma medible?
- ¿Cómo manejan la tensión entre presión de entrega y calidad?
Nos leemos.
Créditos de las imágenes: diagramas de Wikimedia Commons — You are not allowed to view links. You are not allowed to view links. Register or Login or You are not allowed to view links. Register or Login, You are not allowed to view links. You are not allowed to view links. Register or Login or You are not allowed to view links. Register or Login y You are not allowed to view links. You are not allowed to view links. Register or Login or You are not allowed to view links. Register or Login (CC BY-SA / GFDL).
Saludos,
ANTRAX
#92
Noticias Informáticas / Leen mensajes de Signal, Teleg...
Último mensaje por AXCESS - Septiembre 13, 2026, 04:44:02 PMYou are not allowed to view links.
You are not allowed to view links.
Register or Login or You are not allowed to view links.
Register or Login
La policía alemana vigila en secreto aplicaciones de mensajería con un truco sencillo.
Las fuerzas de seguridad alemanas están utilizando funciones integradas en aplicaciones como WhatsApp para supervisar los mensajes de los usuarios sin vulnerar el cifrado ni instalar programas espía en sus teléfonos.
Nuevos documentos publicados por Netzpolitik, un medio alemán especializado en derechos digitales, revelan que la Oficina de Aduanas del país comenzó a probar esta técnica —conocida como «supervisión de aplicaciones de mensajería»— a finales de 2023.
Aunque la agencia de aduanas advirtió que los detalles del método debían tratarse con «extrema cautela» para no comprometer su uso, la técnica no entraña ninguna complejidad técnica extraordinaria.
Aplicaciones como WhatsApp Web y Signal Desktop permiten a los usuarios utilizar sus cuentas en otros dispositivos, como ordenadores portátiles o de escritorio.
La oficina de aduanas de Alemania ha estado utilizando estas funciones para vincular un ordenador controlado por la policía a la cuenta de un sospechoso.
Una vez establecida la conexión, los mensajes pueden recibirse en dicho ordenador sin necesidad de que la policía descifre el cifrado que los protege.
Cómo accede legalmente la policía a los mensajes cifrados
Netzpolitik detalla que la policía puede obtener acceso de esta manera ya sea mediante el acceso físico al teléfono de una persona, interceptando códigos de verificación a través de un ataque de *phishing* autorizado por el Estado o interceptando mensajes SMS mediante vigilancia telefónica.
En el caso de Signal, las autoridades de seguridad alemanas advierten que quien logre vincular otro dispositivo puede acceder a los mensajes de los últimos 45 días.
Respecto a Telegram, Netzpolitik cita un caso relacionado con un presunto traficante de drogas en Baja Sajonia.
La policía se conectó en secreto a su cuenta de Telegram en marzo de 2022. El sospechoso descubrió el acceso unas horas más tarde, pero para entonces la policía ya había copiado su archivo de mensajes.
Según documentos oficiales consultados por Netzpolitik, estas técnicas se convirtieron en una práctica oficial en agosto de 2025, tras constatarse que habían aportado «importantes éxitos en la investigación» de casos de delincuencia grave y organizada.
Sin embargo, Netzpolitik cuestiona la legalidad de este método, el alcance de su uso y los criterios para seleccionar a los objetivos.
La policía federal vigila los mensajes de WhatsApp de una pareja inocente
Netzpolitik cita un caso judicial de 2020 que involucraba a un matrimonio —que no figuraba como sospechoso— para ilustrar cómo se utilizó el acceso físico a los dispositivos para vigilar los teléfonos de personas inocentes.
La pareja entregó voluntariamente sus teléfonos a la policía alemana mientras prestaba declaración como testigo en relación con su hija, permitiendo así que los agentes inspeccionaran y fotografiaran los mensajes que ella les había enviado.
Mientras los teléfonos estaban en poder de la policía, los agentes activaron secretamente WhatsApp Web y vincularon las cuentas a un ordenador operado por la Bundeskriminalamt, u Oficina Federal de Policía Criminal (BKA).
Una vez establecida dicha conexión, la policía podía, potencialmente:
-Leer nuevos mensajes de WhatsApp después de que se devolviera el teléfono
-Ver conversaciones existentes que se habían sincronizado con el ordenador vinculado
-Ver los contactos de WhatsApp
-Enviar mensajes de WhatsApp haciéndose pasar por la pareja
You are not allowed to view links. You are not allowed to view links. Register or Login or You are not allowed to view links. Register or Login
La policía no podía supervisar las llamadas de voz de WhatsApp ni acceder a otras funciones del teléfono, como la cámara, el micrófono, los mensajes SMS convencionales o aplicaciones ajenas a WhatsApp.
La legalidad de estos métodos ha sido cuestionada por el sistema jurídico alemán.
Zona gris legal
En enero, el Tribunal Federal de Justicia de Alemania dictaminó que conectarse en secreto a chats de Telegram de esta manera constituía una forma de vigilancia, rechazando así una interpretación anterior de la ley a la que la unidad de investigación penal de aduanas seguía recurriendo incluso en febrero de este año.
Tal vez debido a que la interceptación de mensajes ha resultado tan eficaz, las autoridades están presionando para obtener un acceso más amplio.
En Estados Unidos, se ha informado que las fuerzas del orden pueden realizar —y han realizado— tareas de vigilancia en dispositivos iOS y Android mediante la interceptación de notificaciones *push*, independientemente de si los usuarios de dichos dispositivos emplean cifrado de extremo a extremo.
Fuente:
CyberNews
You are not allowed to view links. You are not allowed to view links. Register or Login or You are not allowed to view links. Register or Login
#93
Noticias Informáticas / La «primera batalla de la hist...
Último mensaje por AXCESS - Septiembre 13, 2026, 04:41:22 PMYou are not allowed to view links.
You are not allowed to view links.
Register or Login or You are not allowed to view links.
Register or Login
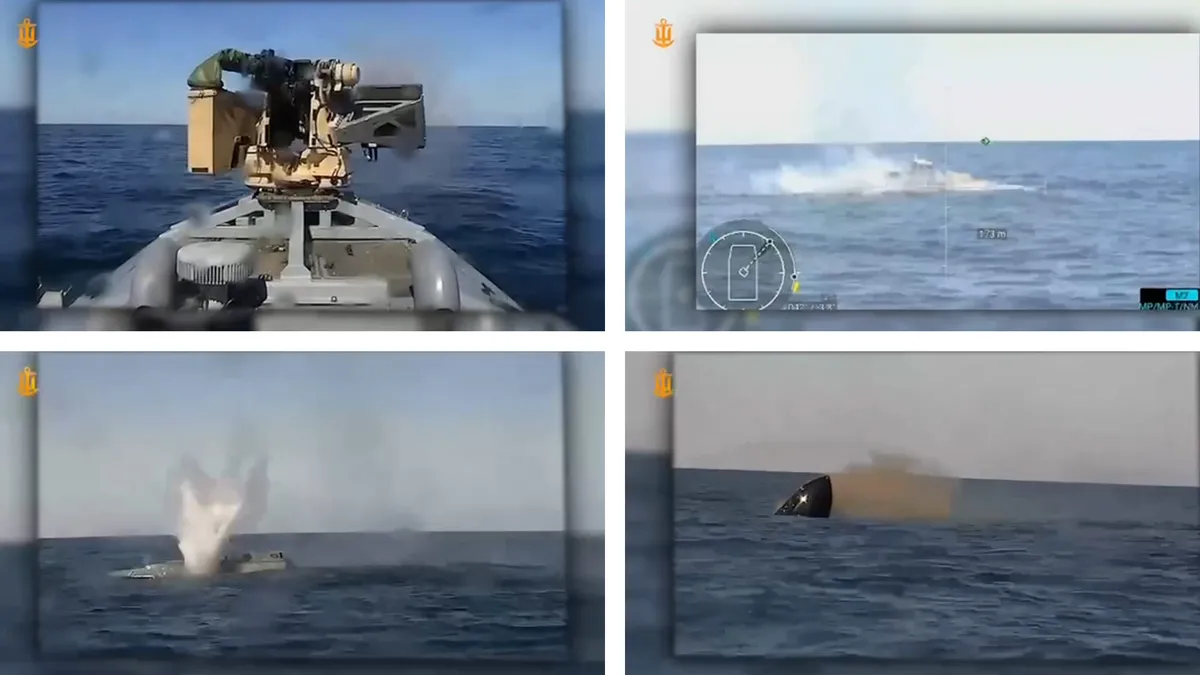
La Armada de Ucrania ha afirmado haber ganado «la primera batalla de la historia entre embarcaciones navales no tripuladas». En un vídeo compartido en el canal oficial de Telegram de la Armada ucraniana, se muestra a su dron marino Sargan 3000 destruyendo una embarcación rusa MBeK en el mar Negro.
En el video se puede ver cómo la embarcación de superficie no tripulada (USV) ucraniana apunta a lo que se identifica como una USV rusa del tipo MBek y dispara varias ráfagas con su torreta automática «Protector RWS» de 12,7 mm. El comunicado oficial de Telegram indica que la USV rusa fue «detectada por unidades de la GUR». Cabe señalar que GUR son las siglas de la Dirección Principal de Inteligencia del Ministerio de Defensa de Ucrania.
Tras recibir los disparos, se produce al menos una explosión y el humo comienza a envolver a la USV rusa. Es evidente que Ucrania también contaba con drones en las inmediaciones, ya que disponemos de imágenes aéreas de este histórico duelo naval entre vehículos no tripulados.
Finalmente —y no se sabe con certeza cuánto duró el combate—, el video muestra al MBeK deslizándose hacia su tumba acuática. La embarcación rusa se hundió hasta el fondo marino en un característico descenso de proa, acribillada y perforada como una bolsita de té.
El Sargan 3000 entró en servicio en la Armada de Ucrania en abril de 2026. Antes de esta última hazaña destacada, el mismo tipo de vehículo de superficie no tripulado (USV) acaparó los titulares a mediados de julio por hundir el *Izumrud*, un buque de patrulla fronteriza del FSB ruso, frente a la costa de la ciudad turística rusa de Gelendzhik.


El dron naval no tripulado de Ucrania es una plataforma polivalente, y su flexibilidad para transportar diversas cargas útiles parece haber sido confirmada mediante imágenes y declaraciones de los operadores. Por ejemplo, el modelo de torreta automática que aparece en el vídeo de hoy podría diferir ligeramente del equipamiento que llevaba la embarcación de recuperación *Izumrud*. Asimismo, se han visto fotografías de variantes de este vehículo de superficie no tripulado (USV) equipadas con un sistema para transportar drones FPV, dos contenedores de transporte y lanzamiento, y una estación de armas por control remoto.
Se estima que el Sargan 3000 tiene una eslora de casi 6,9 metros (23 pies), un radio de combate de cerca de 1.600 kilómetros (1.000 millas) y capacidad para transportar una carga útil de hasta 450 kilogramos (990 libras), alcanzando una velocidad máxima de unos 50 nudos. Se calcula que Ucrania puede producir alrededor de 25 unidades de este modelo al mes.
Fuente:
Tom´s Hardware
You are not allowed to view links. You are not allowed to view links. Register or Login or You are not allowed to view links. Register or Login
La Armada de Ucrania ha afirmado haber ganado «la primera batalla de la historia entre embarcaciones navales no tripuladas». En un vídeo compartido en el canal oficial de Telegram de la Armada ucraniana, se muestra a su dron marino Sargan 3000 destruyendo una embarcación rusa MBeK en el mar Negro.
En el video se puede ver cómo la embarcación de superficie no tripulada (USV) ucraniana apunta a lo que se identifica como una USV rusa del tipo MBek y dispara varias ráfagas con su torreta automática «Protector RWS» de 12,7 mm. El comunicado oficial de Telegram indica que la USV rusa fue «detectada por unidades de la GUR». Cabe señalar que GUR son las siglas de la Dirección Principal de Inteligencia del Ministerio de Defensa de Ucrania.
Tras recibir los disparos, se produce al menos una explosión y el humo comienza a envolver a la USV rusa. Es evidente que Ucrania también contaba con drones en las inmediaciones, ya que disponemos de imágenes aéreas de este histórico duelo naval entre vehículos no tripulados.
Finalmente —y no se sabe con certeza cuánto duró el combate—, el video muestra al MBeK deslizándose hacia su tumba acuática. La embarcación rusa se hundió hasta el fondo marino en un característico descenso de proa, acribillada y perforada como una bolsita de té.
El Sargan 3000 entró en servicio en la Armada de Ucrania en abril de 2026. Antes de esta última hazaña destacada, el mismo tipo de vehículo de superficie no tripulado (USV) acaparó los titulares a mediados de julio por hundir el *Izumrud*, un buque de patrulla fronteriza del FSB ruso, frente a la costa de la ciudad turística rusa de Gelendzhik.
El dron naval no tripulado de Ucrania es una plataforma polivalente, y su flexibilidad para transportar diversas cargas útiles parece haber sido confirmada mediante imágenes y declaraciones de los operadores. Por ejemplo, el modelo de torreta automática que aparece en el vídeo de hoy podría diferir ligeramente del equipamiento que llevaba la embarcación de recuperación *Izumrud*. Asimismo, se han visto fotografías de variantes de este vehículo de superficie no tripulado (USV) equipadas con un sistema para transportar drones FPV, dos contenedores de transporte y lanzamiento, y una estación de armas por control remoto.
Se estima que el Sargan 3000 tiene una eslora de casi 6,9 metros (23 pies), un radio de combate de cerca de 1.600 kilómetros (1.000 millas) y capacidad para transportar una carga útil de hasta 450 kilogramos (990 libras), alcanzando una velocidad máxima de unos 50 nudos. Se calcula que Ucrania puede producir alrededor de 25 unidades de este modelo al mes.
Fuente:
Tom´s Hardware
You are not allowed to view links. You are not allowed to view links. Register or Login or You are not allowed to view links. Register or Login
#94
Noticias Informáticas / La privacidad se está convirti...
Último mensaje por AXCESS - Septiembre 13, 2026, 04:33:13 PMYou are not allowed to view links.
You are not allowed to view links.
Register or Login or You are not allowed to view links.
Register or Login
Las mayores brechas de seguridad reportadas durante la última semana abarcaron diversos sectores e impactaron en todos los aspectos de la vida cotidiana: desde lo que aprenden los niños (brecha de datos en Mathspace) y lo que leen los adultos (presunto hackeo a Condé Nast), hasta los lugares que visitan los soldados (filtración de datos en Polarsteps) e incluso la intimidad de las personas (acuerdo de 35 millones de dólares de Grindr).
Más de 20 millones de personas, incluidos soldados estadounidenses, utilizan Polarsteps para compartir sus viajes. Parece una aplicación especializada y popular más, ¿verdad? Lamentablemente, al igual que cualquier otra aplicación que conecta a aficionados, recopila una gran cantidad de datos, incluidas fotos y ubicaciones de los usuarios.
Según una investigación periodística independiente realizada por *Follow the Money*, Polarsteps dejó expuestos millones de fotos, vídeos y ubicaciones GPS. Los investigadores lograron rastrear a decenas de militares de Estados Unidos, el Reino Unido y los Países Bajos con una precisión de pocos metros, e incluso localizaron puntos sensibles como bases militares y misiones activas en el extranjero.
¿Lo peor de todo? Ni siquiera se trató de un hackeo: la propia empresa permitió que esto sucediera.
Falta rendición de cuentas. Otro ejemplo es el acuerdo de 35 millones de dólares de Grindr. Doce mil usuarios de la aplicación de citas LGBTQ+ más popular demandaron a la empresa, acusándola de compartir datos confidenciales con terceros. Dichos datos incluían, presuntamente, el estado serológico respecto al VIH y las fechas de las pruebas. Sin embargo, estas acusaciones nunca se someterán a juicio, ya que Grindr pagará 35 millones de dólares para resolver la demanda. La compañía subrayó que este acuerdo no constituye una admisión de responsabilidad.
Pero nunca admiten su culpa, así que esto no sorprende en absoluto.
Ver a las marcas tropezar en cuestiones de ciberseguridad hace preguntarse si a alguien realmente le importa. Condé Nast, el gigante mediático propietario de Vogue, The New Yorker, GQ, Glamour y WIRED, también sufrió un hackeo que expuso más de 30 millones de cuentas en la *dark web*. No obstante, los datos no parecen excesivamente sensibles; la información más delicada se limita a nombres, apellidos, fechas de nacimiento y direcciones.
«¿Y qué más da?», podría decirse.
Pero ¿significa eso que deberíamos restarle importancia al hecho de que la empresa no haya logrado proteger sus sistemas? Esto nos lleva a cuestionarnos qué otras cosas estarán dejando de salvaguardar.
También se siente como una traición cuando los dispositivos más cotidianos de nuestro hogar empiezan a vendernos. Y ni hablemos de ese extensor de Wi-Fi barato de Temu que deja la seguridad de tu casa totalmente expuesta a los hackers.
Unos investigadores descubrieron que los televisores LG escaneaban las redes locales e identificaban teléfonos, relojes inteligentes, impresoras y otros dispositivos cercanos. ¿Y para qué quiere LG televisores que espían? Para recopilar datos sobre los hábitos de visualización de los clientes y así crear mejores anuncios. En Estados Unidos, la empresa promociona el acceso a 49 millones de televisores inteligentes LG y a otros 363 millones de dispositivos que podrían convertirse en blanco de publicidad.
Tal vez sea cierto. Quizás realmente no seas una persona tan interesante. Sin embargo, mientras tengas aunque sea un centavo en el bolsillo, nunca estarás verdaderamente solo.
Fuente:
CyberNews
You are not allowed to view links. You are not allowed to view links. Register or Login or You are not allowed to view links. Register or Login
#95
Noticias Informáticas / Incautan granja de criptomoned...
Último mensaje por AXCESS - Septiembre 13, 2026, 04:31:41 PMYou are not allowed to view links.
You are not allowed to view links.
Register or Login or You are not allowed to view links.
Register or Login
Cada vez hay más pruebas de que los cárteles mexicanos de la droga están incursionando en la minería de criptomonedas y utilizando plataformas de criptoactivos para diversificar sus ingresos, lavar sus ganancias ilícitas y financiar otras actividades ilegales.
Reuters informa que la policía local mexicana descubrió una granja clandestina de criptomonedas en Tlaola, una localidad situada en las frondosas montañas de la Sierra Norte de Puebla. En el lugar hallaron 300 unidades de procesamiento gráfico (GPU), infraestructura eléctrica y equipos satelitales. Es probable que esta operación, de alto consumo energético, obtuviera electricidad conectándose clandestinamente a la red de la presa de Necaxa, una central hidroeléctrica cercana.
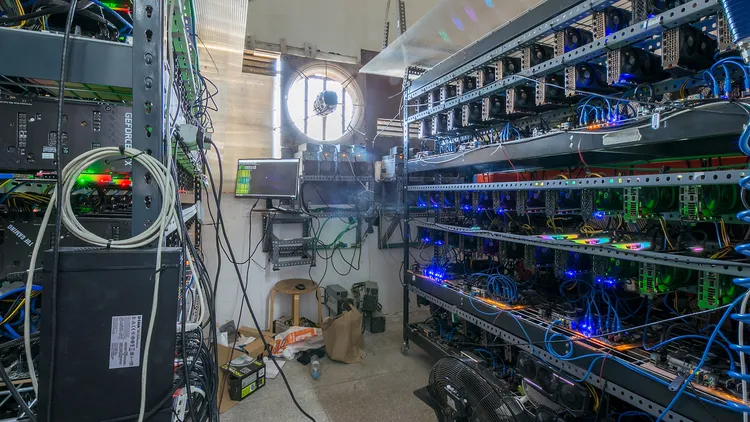
Aunque esta última instalación oculta descubierta por la policía pueda parecer pequeña, Reuters señala que se trata de la cuarta granja de criptomonedas de este tipo que las autoridades mexicanas han hallado en la región desde principios del año pasado. Según un analista de seguridad radicado en México, las granjas de criptomonedas descubiertas demuestran que los cárteles son cada vez más sofisticados en sus operaciones. En esta última intervención, las autoridades federales mexicanas, la Marina y la policía estatal incautaron cerca de 300 unidades de procesamiento gráfico (GPU), 80 terminales de media tensión, un transformador y ocho antenas satelitales.
No resulta sorprendente saber que los cárteles mexicanos están vinculados a las criptomonedas. La firma de análisis de blockchain Chainalysis, citada por Reuters, estima que las transacciones ilícitas con criptomonedas aumentaron de 59.000 millones de dólares en 2024 a 154.000 millones el año pasado. La empresa atribuye este incremento a la evasión de sanciones por parte de gobiernos; sin embargo, en Sudamérica, los cárteles muestran un interés creciente en utilizar esta vía para el blanqueo de capitales. Las operaciones de minería también forman parte de este esquema, dado que para el crimen organizado resulta sencillo robar electricidad. La minería con tarjetas gráficas (GPU) para el mercado de consumo masivo llegó a su fin en la segunda mitad de 2022, lo que inundó el mercado de tarjetas usadas.
El informe original no especifica cómo localizaron las autoridades la granja de criptomonedas. Es posible que los habitantes de esta zona remota de Puebla alertaran a las autoridades sobre la operación. Dos personas de comunidades vecinas declararon a Reuters que podían oír el ruido de la granja (proveniente de transformadores y sistemas de refrigeración) a un kilómetro de distancia, y que el lugar se encontraba, al parecer, a tan solo dos kilómetros del pueblo más cercano. Cabe señalar que las otras tres granjas de criptomonedas descubiertas recientemente también se hallaban cerca de la misma presa hidroeléctrica. Tlaola es una comunidad pequeña de unos 20.000 habitantes, por lo que los niveles de ruido y el consumo eléctrico de estas granjas resultan muy perceptibles, aun cuando los cárteles intenten ocultarlas en lo profundo de la sierra.
Las comunidades remotas, como Tlaola, son lugares habituales para las granjas clandestinas de criptomonedas debido a que la electricidad es económica y muchas de ellas se encuentran bajo la protección de los cárteles. Por ejemplo, el Cártel Jalisco Nueva Generación (CJNG) y su brazo armado, La Barredora, tienen una fuerte presencia en Puebla.
Según SILIKN, una empresa mexicana de ciberseguridad, el uso de la criptominería para el lavado de dinero ilícito aumentó al menos un 55,8 % el año pasado en México. Cárteles de la droga, como el Cártel de Sinaloa y el CJNG, han establecido granjas de criptominería para extraer Bitcoin (BTC), Monero (XMR) y Tether (USDT).
Existen instalaciones de criptominería ilícita en lugares remotos de todo el mundo; Reuters ha reportado redadas en Brasil, Estados Unidos y Tailandia. Mientras tanto, los analistas prevén que los delitos relacionados con las criptomonedas alcanzarán niveles récord en los próximos años.
Fuente:
Tom´s Hardware
You are not allowed to view links. You are not allowed to view links. Register or Login or You are not allowed to view links. Register or Login
Cada vez hay más pruebas de que los cárteles mexicanos de la droga están incursionando en la minería de criptomonedas y utilizando plataformas de criptoactivos para diversificar sus ingresos, lavar sus ganancias ilícitas y financiar otras actividades ilegales.
Reuters informa que la policía local mexicana descubrió una granja clandestina de criptomonedas en Tlaola, una localidad situada en las frondosas montañas de la Sierra Norte de Puebla. En el lugar hallaron 300 unidades de procesamiento gráfico (GPU), infraestructura eléctrica y equipos satelitales. Es probable que esta operación, de alto consumo energético, obtuviera electricidad conectándose clandestinamente a la red de la presa de Necaxa, una central hidroeléctrica cercana.
Aunque esta última instalación oculta descubierta por la policía pueda parecer pequeña, Reuters señala que se trata de la cuarta granja de criptomonedas de este tipo que las autoridades mexicanas han hallado en la región desde principios del año pasado. Según un analista de seguridad radicado en México, las granjas de criptomonedas descubiertas demuestran que los cárteles son cada vez más sofisticados en sus operaciones. En esta última intervención, las autoridades federales mexicanas, la Marina y la policía estatal incautaron cerca de 300 unidades de procesamiento gráfico (GPU), 80 terminales de media tensión, un transformador y ocho antenas satelitales.
No resulta sorprendente saber que los cárteles mexicanos están vinculados a las criptomonedas. La firma de análisis de blockchain Chainalysis, citada por Reuters, estima que las transacciones ilícitas con criptomonedas aumentaron de 59.000 millones de dólares en 2024 a 154.000 millones el año pasado. La empresa atribuye este incremento a la evasión de sanciones por parte de gobiernos; sin embargo, en Sudamérica, los cárteles muestran un interés creciente en utilizar esta vía para el blanqueo de capitales. Las operaciones de minería también forman parte de este esquema, dado que para el crimen organizado resulta sencillo robar electricidad. La minería con tarjetas gráficas (GPU) para el mercado de consumo masivo llegó a su fin en la segunda mitad de 2022, lo que inundó el mercado de tarjetas usadas.
El informe original no especifica cómo localizaron las autoridades la granja de criptomonedas. Es posible que los habitantes de esta zona remota de Puebla alertaran a las autoridades sobre la operación. Dos personas de comunidades vecinas declararon a Reuters que podían oír el ruido de la granja (proveniente de transformadores y sistemas de refrigeración) a un kilómetro de distancia, y que el lugar se encontraba, al parecer, a tan solo dos kilómetros del pueblo más cercano. Cabe señalar que las otras tres granjas de criptomonedas descubiertas recientemente también se hallaban cerca de la misma presa hidroeléctrica. Tlaola es una comunidad pequeña de unos 20.000 habitantes, por lo que los niveles de ruido y el consumo eléctrico de estas granjas resultan muy perceptibles, aun cuando los cárteles intenten ocultarlas en lo profundo de la sierra.
Las comunidades remotas, como Tlaola, son lugares habituales para las granjas clandestinas de criptomonedas debido a que la electricidad es económica y muchas de ellas se encuentran bajo la protección de los cárteles. Por ejemplo, el Cártel Jalisco Nueva Generación (CJNG) y su brazo armado, La Barredora, tienen una fuerte presencia en Puebla.
Según SILIKN, una empresa mexicana de ciberseguridad, el uso de la criptominería para el lavado de dinero ilícito aumentó al menos un 55,8 % el año pasado en México. Cárteles de la droga, como el Cártel de Sinaloa y el CJNG, han establecido granjas de criptominería para extraer Bitcoin (BTC), Monero (XMR) y Tether (USDT).
Existen instalaciones de criptominería ilícita en lugares remotos de todo el mundo; Reuters ha reportado redadas en Brasil, Estados Unidos y Tailandia. Mientras tanto, los analistas prevén que los delitos relacionados con las criptomonedas alcanzarán niveles récord en los próximos años.
Fuente:
Tom´s Hardware
You are not allowed to view links. You are not allowed to view links. Register or Login or You are not allowed to view links. Register or Login
#96
Cursos, manuales y libros / Re:English magazine collection
Último mensaje por Proculin - Septiembre 13, 2026, 06:04:44 AMThe New York Times Best Sellers: Fiction – September 13, 2026

Language: English | Format: epub |2026| Size: 40 MB
List:
01. THEO OF GOLDEN by Allen Levi
02. BIG LITTLE TRUTHS by Liane Moriarty
03. THE CALAMITY CLUB by Kathryn Stockett
04. YESTERYEAR by Caro Claire Burke
05. DUNGEON CRAWLER CARL by Matt Dinniman
06. BRAIN DAMAGE by Freida McFadden (2016)
07. WHISTLER by Ann Patchett
08. DELUSIONAL by James Patterson and James O. Born
09. MAD MABEL by Sally Hepworth
10. PROJECT HAIL MARY by Andy Weir
11. CARL'S DOOMSDAY SCENARIO by Matt Dinniman
12. THE CORRESPONDENT by Virginia Evans
13. HEART OF GLASS by Jennifer Hillier
14. DAGGERBOUND by T. Kingfisher
15. VERITY by Colleen Hoover
Código: text
Language: English | Format: epub |2026| Size: 40 MB
List:
01. THEO OF GOLDEN by Allen Levi
02. BIG LITTLE TRUTHS by Liane Moriarty
03. THE CALAMITY CLUB by Kathryn Stockett
04. YESTERYEAR by Caro Claire Burke
05. DUNGEON CRAWLER CARL by Matt Dinniman
06. BRAIN DAMAGE by Freida McFadden (2016)
07. WHISTLER by Ann Patchett
08. DELUSIONAL by James Patterson and James O. Born
09. MAD MABEL by Sally Hepworth
10. PROJECT HAIL MARY by Andy Weir
11. CARL'S DOOMSDAY SCENARIO by Matt Dinniman
12. THE CORRESPONDENT by Virginia Evans
13. HEART OF GLASS by Jennifer Hillier
14. DAGGERBOUND by T. Kingfisher
15. VERITY by Colleen Hoover
https://mega4upload.net/8w53q8avpjm9
https://rg.to/file/a99c1226fa47bd3d7bea692df3a27d34
https://uploady.io/wpi98xet965n/NBS13Sep26fiction.rar
https://www.up-4ever.net/p15myhuekiaa
#97
QA (Quality Assurance) / Agentes de IA para testing: qu...
Último mensaje por ANTRAX - Septiembre 12, 2026, 11:02:44 PM
Buenas gente. En el post anterior sobre Playwright quedó picando un tema que hoy es imposible de esquivar en QA: los agentes de IA. La industria está llena de humo al respecto, así que la idea de este post es separar lo que realmente anda de lo que todavía es marketing, y sobre todo mostrar cómo se monta esto en la práctica, con comandos y configuración concreta.
Aviso desde el arranque: esto no reemplaza al QA. Lo que hace es correr la parte mecánica del trabajo. Quien decide qué vale la pena probar y si un fallo es real seguís siendo vos.
1. Tres niveles distintos (y no son lo mismo)
Cuando alguien dice "uso IA para testear" puede estar hablando de tres cosas muy diferentes:
[list=1]
- Asistente: le pedís a un chat que te escriba un test y lo pegás. La IA no ve tu app, no ejecuta nada, no verifica nada. Es autocompletado con esteroides. Útil, pero el código sale plausible, no correcto.
- Agente en el loop de desarrollo: la IA tiene herramientas. Abre un navegador real, navega tu app, escribe el test, lo corre, ve que falla, lo corrige y vuelve a correrlo hasta que pasa. Acá está el 90% del valor real hoy.
- Agente autónomo en runtime: no hay script. El agente explora la app sola y decide qué probar en cada corrida. Suena increíble y es donde está casi todo el humo: es no determinista, caro, y difícil de auditar.
La diferencia entre el nivel 1 y el 2 es el ciclo de verificación. Un modelo que no puede ejecutar lo que escribe está adivinando. Uno que ejecuta, ve el error y corrige, converge. Es exactamente la misma diferencia que hay entre escribir código a ciegas y escribirlo con un compilador al lado.
2. Cómo funciona un agente por dentro
Un agente no es magia, es un bucle. Literalmente esto:
   ┌─────────────────────────────────────────────────┐
   │                                                 │
   ▼                                                 │
┌──────────┐   "abrí /login y                  ┌──────────┐
│  MODELO  │──── contame qué ves" ────────────▶│ HERRAMIENTAS│
│  (LLM)   │                                   │  browser  │
│          │◀─── árbol de accesibilidad, ──────│  archivos │
└──────────┘     errores, screenshots          │  shell    │
   │                                           └──────────┘
   │ ¿terminé?
   ▼
┌──────────────────────┐
│ test.spec.ts escrito │
│ y verificado         │
└──────────────────────┘
El modelo pide una acción, una herramienta la ejecuta de verdad, el resultado vuelve al modelo, y así hasta que la tarea está cumplida. Todo lo demás (frameworks, productos, suscripciones) es packaging alrededor de este bucle.
El detalle técnico que más importa: qué le mandás al modelo como "lo que ve". Hay dos escuelas:
- Píxeles: le mandás un screenshot y el modelo decide dónde clickear por coordenadas. Caro en tokens, lento y frágil.
- Árbol de accesibilidad: le mandás la estructura semántica de la página (roles, nombres, estados) como texto. Es órdenes de magnitud más barato, más rápido y determinista.
En 2026 ganó la segunda por goleada, y es la razón por la que Playwright quedó tan bien parado en este terreno: su modelo de locators ya era semántico antes de que existieran los agentes.
3. MCP: el enchufe estándar
MCP (Model Context Protocol) es un protocolo abierto que estandariza cómo un modelo accede a herramientas externas. Antes de MCP, cada integración era un adaptador propietario. Ahora un servidor MCP expone herramientas y cualquier cliente compatible las consume.
Para QA esto importa porque existe @playwright/mcp, el servidor oficial de Microsoft que expone el control del navegador como herramientas MCP. Configuración típica en un cliente:
{
  "mcpServers": {
    "playwright": {
      "command": "npx",
      "args": ["@playwright/mcp@latest"]
    }
  }
}
Con eso, el agente puede abrir páginas, interactuar con el DOM, correr tests y leer los artefactos que Playwright produce: traces, screenshots, videos y logs de red. Esto último es lo más subestimado: el agente no sólo actúa, también diagnostica con la misma información que usarías vos.
Un consejo de configuración que ahorra dolores: podés restringirlo.
{
  "mcpServers": {
    "playwright": {
      "command": "npx",
      "args": [
        "@playwright/mcp@latest",
        "--headless",
        "--isolated",
        "--allowed-origins", "http://localhost:3000;https://staging.miapp.com"
      ]
    }
  }
}
--allowed-origins es importante de verdad. Un agente con un navegador sin restricciones es un navegador que puede ir a cualquier lado con las cookies de tu sesión. Tratalo como lo que es: un proceso automatizado con acceso a red.
4. Playwright Agents: planner, generator y healer
Esto ya viene integrado en Playwright, no es un producto de terceros. Son tres agentes que se pueden usar por separado o en cadena:
- 🎭 Planner — explora la aplicación y produce un plan de pruebas en Markdown, legible por humanos, basado en los flujos de usuario que encuentra.
- 🎭 Generator — transforma ese plan en archivos de test de Playwright, verificando selectores y assertions contra la app real mientras los escribe.
- 🎭 Healer — ejecuta la suite y repara los tests que fallan: replica los pasos, inspecciona la UI, identifica el arreglo y vuelve a correr hasta que pasan.
Se inicializan con un comando, eligiendo con qué cliente los vas a manejar:
npx playwright init-agents --loop=vscode
npx playwright init-agents --loop=claude
npx playwright init-agents --loop=codex
npx playwright init-agents --loop=opencode
Ese comando genera las definiciones de los agentes en tu repo. Conviene volver a correrlo cuando actualizás Playwright, porque las definiciones traen las herramientas e instrucciones de la versión, y quedarse con las viejas te deja sin capacidades nuevas.
El flujo que sale de esto es bastante distinto al tradicional:
App corriendo
     │
     ▼
 [PLANNER] ──▶ specs/plan.md          ← acá revisás VOS
     │                                   (esto es el control de calidad)
     ▼
[GENERATOR] ─▶ tests/*.spec.ts        ← código determinista, versionado
     │
     ▼
  npx playwright test  ──── falla ───▶ [HEALER] ──▶ propone el arreglo
     │                                                     │
     └────────────────── pasa ◀────────────────────────────┘
El punto clave está en el primer paso: el plan sale en Markdown a propósito. Es el momento donde un humano lee "voy a probar login, checkout y recuperación de contraseña" y dice "falta el flujo de cupones vencidos, que es donde siempre se rompe". Ese es el trabajo de QA que la IA no hace.
Y el resultado final es código Playwright normal. Determinista, en git, revisable en un PR, que corre en CI sin llamar a ningún modelo. Eso es lo que separa un enfoque serio de una caja negra que cobra por corrida.
5. Triage automático de fallos en CI
Este caso de uso es, en mi experiencia, el de mejor relación valor/esfuerzo y casi nadie lo aprovecha.
El escenario clásico: la suite falla de noche en CI, a la mañana hay 14 tests en rojo y alguien tiene que abrir uno por uno para descubrir que 12 fallan por la misma causa. Un agente con acceso a los traces hace ese agrupamiento en minutos:
# el agente recibe la carpeta de artefactos y produce un resumen
npx playwright test --reporter=json > resultados.json
# → agente: leer resultados.json + traces, agrupar por causa raíz
La salida útil no es "14 tests fallaron", es:
GRUPO 1 (12 tests) — el endpoint /api/session devuelve 502
  → causa compartida, backend. No es un problema de los tests.
GRUPO 2 (1 test)  — el botón "Continuar" cambió de nombre a "Siguiente"
  → cambio legítimo de UI, el test necesita actualizarse.
GRUPO 3 (1 test)  — flaky: pasó en el reintento, race condition en el toast
  → revisar espera, no es regresión.
Eso convierte cuarenta minutos de trabajo tedioso en una revisión de dos minutos. Y no requiere confiar en la IA para nada crítico: sólo está ordenando información, vos seguís decidiendo.
6. Armar tu propio agente
Si querés algo a medida, no hace falta un producto. El bucle es corto. Ejemplo mínimo en Python con la API de Claude:
import anthropic

client = anthropic.Anthropic()

resp = client.messages.create(
    model="claude-opus-5",
    max_tokens=16000,
    thinking={"type": "adaptive"},
    output_config={"effort": "high"},
    tools=[{
        "name": "correr_test",
        "description": "Ejecuta un archivo de test de Playwright y devuelve stdout/stderr.",
        "input_schema": {
            "type": "object",
            "properties": {"archivo": {"type": "string"}},
            "required": ["archivo"],
            "additionalProperties": False,
        },
        "strict": True,
    }],
    messages=[{
        "role": "user",
        "content": "Corré tests/login.spec.ts y si falla, decime la causa raíz.",
    }],
)

for bloque in resp.content:
    if bloque.type == "tool_use":
        print("quiere ejecutar:", bloque.input)
Vos ejecutás la herramienta, devolvés el resultado como `tool_result` y repetís mientras `stop_reason == "tool_use"`. Eso es todo el agente. Un detalle importante de diseño: poné el gate de aprobación en tu código, no en el prompt. Si una herramienta puede borrar datos, que tu función pida confirmación; pedirle al modelo que "no borre nada" no es un control de seguridad.
7. Qué funciona y qué no (sin vender humo)
Funciona hoy:
- Generación de tests a partir de una URL o un flujo descrito en lenguaje natural.
- Reparación de locators rotos por cambios de maquetado.
- Generación de tests unitarios con cobertura alta sobre código existente.
- Triage y agrupamiento de fallos en CI.
- Regresión visual con filtrado inteligente (menos falsos positivos por un píxel de antialiasing).
Todavía es humo:
- Reemplazar al QA. Nadie serio sostiene esto. La IA genera casos; decidir qué importa probar es criterio de producto y de riesgo.
- Diagnóstico de causa raíz confiable. Agrupa bien, pero atribuye mal con frecuencia.
- Testing no supervisado de lógica de negocio compleja. El agente no sabe que un descuento del 110% es un bug si nadie se lo dijo.
- Self-healing sin revisión. Y este merece párrafo aparte.
8. El riesgo serio del self-healing
Un healer que arregla tests solo y mergea sin que nadie mire es una máquina de ocultar bugs. Pensalo: el test falla porque el botón "Comprar" desapareció. El agente busca un elemento parecido, encuentra "Ver más", actualiza el locator, el test pasa, el pipeline queda verde. Acabás de automatizar el borrado de la evidencia de una regresión en producción.
La regla es simple y no tiene excepciones: todo arreglo de un agente entra por pull request y lo revisa una persona. Nunca commit directo, nunca auto-merge. El agente propone, el humano dispone. Si la única lectura que le dedicás es ver el check en verde, desactivá el healer, porque te está perjudicando.
9. Costos
Vale aclararlo porque suele sorprender: los agentes gastan tokens, y un bucle mal armado los quema rápido. Tres cosas que bajan la factura de forma inmediata:
- Árbol de accesibilidad en vez de screenshots siempre que se pueda. La diferencia es enorme.
- Prompt caching si mandás el mismo contexto de proyecto en cada corrida.
- Nunca en el camino crítico del CI. El agente genera y repara en desarrollo; el CI corre código determinista que no llama a ningún modelo. Esto además hace tu pipeline reproducible y rápido.
10. Por dónde empezar
Si nunca tocaste esto, esta secuencia funciona:
[list=1]
- Instalá Playwright en un proyecto real y conseguí que corra un test a mano. Sin esto, lo demás no tiene sentido.
- `npx playwright init-agents --loop=<tu cliente>`.
- Corré el planner sobre un flujo chico y leé el plan que genera. Vas a aprender más de las limitaciones de la herramienta en esos cinco minutos que en veinte artículos.
- Generá esos tests y revisá el código como revisarías el PR de alguien que recién entró: mirá los locators y las assertions con lupa.
- Recién ahí sumá healer, y siempre vía PR.
El resumen honesto: un agente de IA es un junior muy rápido, incansable y sin criterio propio. Le delegás el trabajo mecánico —escribir el andamiaje, actualizar locators, ordenar fallos—, y te quedás vos con lo que realmente define la calidad: decidir qué probar, qué riesgo importa y si un resultado en verde significa algo.
Quien use esto para escribir más tests va a tener más tests. Quien lo use para liberar tiempo y pensar mejor qué probar, va a tener mejores tests. No es lo mismo.
¿Alguien ya lo tiene andando en un proyecto real? Me interesa saber sobre todo cómo manejan la revisión de lo que genera el agente cuando el volumen crece, que me parece el cuello de botella no resuelto.
Saludos!
#98
QA (Quality Assurance) / Playwright: guia completa de a...
Último mensaje por ANTRAX - Septiembre 12, 2026, 10:57:13 PMBuenas gente de Underc0de. En esta sección se habla bastante de automatización, así que armé una guía sobre Playwright, que en los últimos años se convirtió en una de las herramientas más sólidas para testing end-to-end. La idea es cubrir desde qué es y cómo funciona por dentro, hasta cómo configurarlo, escribir pruebas mantenibles y meterlo en un pipeline de CI.
1. ¿Qué es Playwright?
Playwright es un framework de automatización de navegadores desarrollado por Microsoft. Permite controlar Chromium, Firefox y WebKit (el motor de Safari) con una única API, lo que significa que una misma suite de pruebas corre sobre los tres motores de renderizado principales sin reescribir nada.
Aunque su uso más común es el testing end-to-end, también sirve para scraping, automatización de tareas repetitivas en la web, generación de PDFs o capturas, y monitoreo sintético de aplicaciones en producción.
Tiene bindings oficiales para JavaScript/TypeScript, Python, .NET y Java. En esta guía voy a usar TypeScript porque es donde el ecosistema está más maduro (el test runner propio, @playwright/test, sólo existe para JS/TS), pero los conceptos aplican igual a los demás lenguajes.
2. ¿Por qué no Selenium?
La diferencia clave es arquitectónica. Selenium se comunica con el navegador mediante el protocolo WebDriver, que funciona por HTTP: cada comando es una petición y una respuesta independientes. Eso introduce latencia y, sobre todo, deja al framework ciego respecto de lo que pasa dentro de la página entre comando y comando.
Playwright usa un único canal WebSocket persistente hacia el navegador (basado en el Chrome DevTools Protocol y equivalentes). Esto le permite:
- Auto-waiting real: antes de interactuar con un elemento, verifica que esté visible, estable (sin animaciones), habilitado y capaz de recibir eventos. Adiós a los sleep(3) desparramados por todo el código.
- Interceptar red: mockear respuestas de APIs, simular fallos o modo offline, sin tocar el backend.
- Aislamiento por contexto: cada test corre en un BrowserContext, que es como un perfil de navegador limpio (cookies, localStorage y caché propios) pero que arranca en milisegundos, no en segundos. Esto es lo que permite paralelizar de verdad.
- Manejo nativo de iframes, pestañas, descargas, permisos y shadow DOM, que en otras herramientas suelen ser un dolor de cabeza.
Comparado con Cypress, la ventaja principal es que Playwright no corre dentro del navegador, con lo cual no sufre las limitaciones de same-origin, soporta múltiples pestañas y dominios en un mismo test, y tiene soporte real de WebKit.
3. Instalación
Lo más simple es usar el inicializador, que crea la estructura, el archivo de configuración y un workflow de CI de ejemplo:
npm init playwright@latestTe va a preguntar si querés TypeScript o JavaScript, dónde poner los tests y si querés el workflow de GitHub Actions. Si preferís hacerlo a mano:
npm install -D @playwright/test
npx playwright install --with-deps
Ese segundo comando es importante: Playwright descarga sus propias builds de los navegadores en lugar de usar los que tenés instalados. Puede parecer pesado, pero es lo que garantiza que el test que pasa en tu máquina pase igual en CI. El flag --with-deps instala además las librerías de sistema que los navegadores necesitan en Linux, que es lo que suele romper dentro de los contenedores.
4. Configuración: playwright.config.ts
Acá está el corazón de la herramienta. Una configuración razonable para un proyecto real:
import { defineConfig, devices } from '@playwright/test';

export default defineConfig({
  testDir: './tests',
  fullyParallel: true,
  forbidOnly: !!process.env.CI,
  retries: process.env.CI ? 2 : 0,
  workers: process.env.CI ? 2 : undefined,
  reporter: [['html'], ['list']],

  use: {
    baseURL: process.env.BASE_URL || 'http://localhost:3000',
    trace: 'on-first-retry',
    screenshot: 'only-on-failure',
    video: 'retain-on-failure',
    actionTimeout: 10000,
  },

  projects: [
    { name: 'chromium', use: { ...devices['Desktop Chrome'] } },
    { name: 'firefox',  use: { ...devices['Desktop Firefox'] } },
    { name: 'webkit',   use: { ...devices['Desktop Safari'] } },
    { name: 'mobile',   use: { ...devices['Pixel 7'] } },
  ],

  webServer: {
    command: 'npm run start',
    url: 'http://localhost:3000',
    reuseExistingServer: !process.env.CI,
  },
});
Repaso lo que más importa:
- fullyParallel: corre los tests de un mismo archivo en paralelo, no sólo los archivos entre sí.
- retries: reintentos sólo en CI. Ojo, esto es una red de contención para inestabilidad de infraestructura, no una excusa para dejar tests flaky. Si un test necesita 2 reintentos siempre, está roto.
- forbidOnly: hace fallar el build si alguien se olvidó un test.only en el código. Simple y salva mucho.
- trace: 'on-first-retry': mi favorito, lo explico más abajo.
- projects: cada entrada es una corrida completa de la suite con distinta configuración. Sirve para multi-navegador, para viewports móviles, o para separar tests por entorno.
- webServer: levanta tu aplicación automáticamente antes de correr y la baja al terminar. Evita el clásico "me falla porque no levanté el server".
5. Escribiendo pruebas: locators y assertions
Un test básico:
import { test, expect } from '@playwright/test';

test('un usuario puede iniciar sesión', async ({ page }) => {
  await page.goto('/login');

  await page.getByLabel('Usuario').fill('antrax');
  await page.getByLabel('Contraseña').fill('hunter2');
  await page.getByRole('button', { name: 'Ingresar' }).click();

  await expect(page.getByRole('heading', { name: 'Panel' })).toBeVisible();
  await expect(page).toHaveURL('/dashboard');
});
Notá que no hay una sola espera explícita. Cada acción espera sola a que el elemento esté listo, y cada expect reintenta hasta que se cumple la condición o vence el timeout.
El punto más importante para la mantenibilidad a largo plazo es cómo seleccionás los elementos. El orden de preferencia recomendado es:
[list=1]
- getByRole() — por rol de accesibilidad y nombre accesible. Es el más robusto porque refleja cómo un usuario (y un lector de pantalla) percibe la página.
- getByLabel(), getByPlaceholder(), getByText() — semánticos y legibles.
- getByTestId() — para cuando no hay nada semántico a mano. Requiere agregar data-testid en el código de la app.
- Selectores CSS o XPath — último recurso. Un div > div:nth-child(3) > span se rompe con el próximo cambio de maquetado.
Un detalle conceptual importante: un locator en Playwright es perezoso. Escribir page.getByRole('button') no busca nada en ese momento; sólo describe cómo encontrar el elemento. La búsqueda ocurre recién al usarlo. Por eso podés guardar un locator en una variable y reutilizarlo aunque el DOM se haya vuelto a renderizar, sin el temido StaleElementReferenceException de Selenium.
6. Page Object Model
Cuando la suite crece, conviene encapsular la interacción con cada pantalla:
export class LoginPage {
  constructor(private page: Page) {}

  usuario  = () => this.page.getByLabel('Usuario');
  password = () => this.page.getByLabel('Contraseña');
  submit   = () => this.page.getByRole('button', { name: 'Ingresar' });

  async login(user: string, pass: string) {
    await this.page.goto('/login');
    await this.usuario().fill(user);
    await this.password().fill(pass);
    await this.submit().click();
  }
}
Así, si mañana cambia el formulario, tocás un solo archivo y no cincuenta tests.
7. Las tres herramientas que más tiempo ahorran
Codegen. Abre un navegador, grabás lo que hacés a mano y te escribe el test:
npx playwright codegen https://tu-sitio.comNo lo uses como salida final, porque genera código verboso, pero para descubrir qué locator usar en un componente raro es rapidísimo.
Trace Viewer. Esta es la killer feature. Con trace: 'on-first-retry', cuando un test falla en CI se genera un archivo con la línea de tiempo completa: un snapshot del DOM antes y después de cada acción, el log de red, la consola y el código fuente sincronizado. Lo abrís con:
npx playwright show-trace trace.zipPodés retroceder al momento exacto del fallo e inspeccionar el DOM como si tuvieras las DevTools abiertas ahí. Se acabó el "en mi máquina anda" y el debuggear a fuerza de screenshots.
Modo UI. Para desarrollo local:
npx playwright test --uiWatch mode, viaje en el tiempo entre pasos y selección visual de locators.
8. Interceptar la red
Para tests deterministas conviene aislar el frontend del backend:
test('muestra un mensaje si la API falla', async ({ page }) => {
  await page.route('**/api/usuarios', route =>
    route.fulfill({ status: 500, body: '{"error":"boom"}' })
  );
  await page.goto('/usuarios');
  await expect(page.getByText('No pudimos cargar')).toBeVisible();
});
Poder probar los caminos de error sin tener que tirar abajo un servicio real es algo que en Selenium requiere infraestructura aparte.
9. Autenticación reutilizable
Loguearse por UI en cada test es lento. La solución es hacerlo una vez en un setup, guardar el estado de sesión y reusarlo:
// auth.setup.ts
setup('autenticar', async ({ page }) => {
  await page.goto('/login');
  await page.getByLabel('Usuario').fill(process.env.TEST_USER);
  await page.getByLabel('Contraseña').fill(process.env.TEST_PASS);
  await page.getByRole('button', { name: 'Ingresar' }).click();
  await page.context().storageState({ path: 'playwright/.auth/user.json' });
});
Después, en el config, los proyectos que dependan de ese setup arrancan con storageState ya cargado y autenticados. En suites grandes esto baja los tiempos de minutos a segundos.
10. Integración con CI
Un workflow mínimo de GitHub Actions:
name: e2e
on: [push, pull_request]
jobs:
  test:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - uses: actions/setup-node@v4
        with: { node-version: 20 }
      - run: npm ci
      - run: npx playwright install --with-deps
      - run: npx playwright test
      - uses: actions/upload-artifact@v4
        if: always()
        with:
          name: playwright-report
          path: playwright-report/
El if: always() es clave: querés el reporte y los traces especialmente cuando la corrida falla.
Para proyectos grandes se puede paralelizar con sharding (--shard=1/4) repartiendo la suite entre varias máquinas y juntando los reportes al final.
11. Buenas prácticas
- Tests independientes. Ninguno debe depender de que otro haya corrido antes. Si necesitan datos previos, creálos vía API en un fixture, no por UI.
- Nada de esperas fijas. waitForTimeout es casi siempre el síntoma de que estás esperando lo que no corresponde. Esperá una condición concreta: un elemento, una respuesta de red, una URL.
- Respetá la pirámide de testing. E2E es la capa más cara y más lenta. Cubrí los flujos críticos de negocio acá, y el resto con tests unitarios y de integración.
- Un concepto por test. Los tests largos que validan diez cosas son imposibles de diagnosticar cuando fallan.
- Secretos por variables de entorno, nunca hardcodeados en el repo. Acá en Underc0de no hace falta aclararlo, pero por las dudas queda dicho.
En resumen: Playwright resuelve de raíz los problemas que históricamente hicieron odiar al testing E2E, que eran la inestabilidad, la lentitud y lo difícil que resultaba diagnosticar un fallo en CI. La curva de aprendizaje es corta si venís de cualquier otro framework, y el Trace Viewer por sí solo ya justifica la migración.
¿Alguien lo está usando en producción? Me interesa leer experiencias con suites grandes, sobre todo cómo manejan los tiempos de ejecución y el sharding.
Saludos!
#99
QA (Quality Assurance) / Playwright vs Selenium vs Cypr...
Último mensaje por ANTRAX - Septiembre 12, 2026, 10:55:39 PMCada vez que alguien arranca con automatización de pruebas aparece la misma pregunta: ¿cuál de los tres? La respuesta corta es que no hay un ganador universal, pero sí hay decisiones que se vuelven obvias cuando entendés cómo funciona cada uno por dentro. Casi todas las diferencias prácticas salen de ahí.
La diferencia de fondo: la arquitectura
Selenium habla con el navegador desde afuera usando WebDriver, que es un estándar del W3C. Tu código le manda órdenes a un driver, el driver se las pasa al navegador. Al ser un estándar abierto, cualquier navegador que lo implemente funciona — por eso Selenium corre en prácticamente todos lados, incluso en navegadores viejos o de nicho.
Cypress hace lo contrario: corre adentro del navegador, en el mismo event loop que tu aplicación. Eso le da un acceso privilegiado al estado de la app y una experiencia de depuración muy superior. También le impone límites que no son bugs, son consecuencias del diseño.
Playwright va por afuera como Selenium, pero en vez del protocolo estándar usa los protocolos de depuración nativos de cada navegador, con una conexión persistente. Gana velocidad y control fino (interceptar red, múltiples pestañas, varios orígenes) a cambio de depender de los navegadores que el equipo de Playwright mantiene.
Tabla comparativa
El mismo test en los tres
Nada explica mejor las diferencias que ver el mismo caso escrito tres veces. Login y verificación de que llegamos al panel.
Selenium (Python)
Código: python
Cypress
Código: javascript
Playwright
Código: javascript
Fíjense en el detalle que más impacta en el día a día: en Selenium la espera es responsabilidad tuya. En los otros dos viene de fábrica. Esa sola diferencia explica buena parte de los tests inestables que se ven en proyectos con Selenium mal armado.
Cuándo elegir cada uno
Selenium si:
Cypress si:
Playwright si:
Cosas que no suelen aparecer en las comparativas
La herramienta no arregla una mala estrategia. Un test suite lento y frágil en Selenium va a seguir siendo lento y frágil en Playwright si el problema son los selectores acoplados al DOM, la falta de datos de prueba controlados o testear por la interfaz cosas que se testean mejor por API.
El costo de migrar es real. Cambiar de framework no es solo reescribir tests: es reescribir helpers, fixtures, integración con CI, reportes y la costumbre del equipo. Si lo que tenés funciona, la pregunta no es "cuál es mejor" sino "qué problema concreto me está costando plata".
La brecha se está achicando. WebDriver BiDi es el estándar que busca darle a Selenium las capacidades bidireccionales que hoy son ventaja de Playwright. En un par de años varias de estas diferencias van a pesar menos.
El mejor selector es el que no depende del CSS. Independientemente del framework: roles de accesibilidad, etiquetas y atributos dedicados de test envejecen mucho mejor que una cadena de clases.
Cierre
Si tuviera que resumirlo en una línea: Playwright es la opción por defecto para proyectos nuevos, Cypress gana cuando la prioridad es que el equipo de frontend adopte testing sin resistencia, y Selenium sigue siendo imbatible en diversidad de lenguajes, navegadores y escenarios corporativos.
¿Ustedes qué están usando? Me interesa especialmente escuchar casos de migración: qué los empujó a cambiar y si valió la pena. Y si están arrancando y no saben por dónde, cuenten el contexto (lenguaje del equipo, tipo de app, si hay CI) y vemos entre todos.
Artículo elaborado con asistencia de IA y revisado antes de publicar.
La diferencia de fondo: la arquitectura
Selenium habla con el navegador desde afuera usando WebDriver, que es un estándar del W3C. Tu código le manda órdenes a un driver, el driver se las pasa al navegador. Al ser un estándar abierto, cualquier navegador que lo implemente funciona — por eso Selenium corre en prácticamente todos lados, incluso en navegadores viejos o de nicho.
Cypress hace lo contrario: corre adentro del navegador, en el mismo event loop que tu aplicación. Eso le da un acceso privilegiado al estado de la app y una experiencia de depuración muy superior. También le impone límites que no son bugs, son consecuencias del diseño.
Playwright va por afuera como Selenium, pero en vez del protocolo estándar usa los protocolos de depuración nativos de cada navegador, con una conexión persistente. Gana velocidad y control fino (interceptar red, múltiples pestañas, varios orígenes) a cambio de depender de los navegadores que el equipo de Playwright mantiene.
Tabla comparativa
| Selenium | Cypress | Playwright | |
| Lenguajes | Java, Python, C#, Ruby, JS, Kotlin | Solo JS/TS | JS/TS, Python, Java, .NET |
| Navegadores | Todos los que implementen WebDriver | Chrome, Firefox, Electron (WebKit experimental) | Chromium, Firefox y WebKit |
| Espera automática | No, la manejás vos | Sí, integrada | Sí, integrada |
| Paralelismo | Con Selenium Grid | Requiere Cypress Cloud u orquestación propia | Incluido y gratuito |
| Varias pestañas / orígenes | Sí | Limitado por diseño | Sí, nativo |
| Madurez del ecosistema | La mayor, desde 2004 | Media | Creciendo rápido |
| Curva de aprendizaje | Más empinada | La más amable | Intermedia |
El mismo test en los tres
Nada explica mejor las diferencias que ver el mismo caso escrito tres veces. Login y verificación de que llegamos al panel.
Selenium (Python)
from selenium import webdriver
from selenium.webdriver.common.by import By
from selenium.webdriver.support.ui import WebDriverWait
from selenium.webdriver.support import expected_conditions as EC

driver = webdriver.Chrome()
driver.get("https://ejemplo.com/login")

driver.find_element(By.ID, "usuario").send_keys("[email protected]")
driver.find_element(By.ID, "password").send_keys("secreto")
driver.find_element(By.CSS_SELECTOR, "button[type=submit]").click()

# La espera es explícita: si no la ponés, el test es inestable.
WebDriverWait(driver, 10).until(
    EC.text_to_be_present_in_element((By.CSS_SELECTOR, "h1"), "Panel")
)

driver.quit()
Cypress
it('inicia sesión correctamente', () => {
  cy.visit('/login')
  cy.get('#usuario').type('[email protected]')
  cy.get('#password').type('secreto')
  cy.get('button[type=submit]').click()

  // No hay waits: cada comando reintenta hasta que se cumple o expira.
  cy.get('h1').should('contain', 'Panel')
})
Playwright
test('inicia sesión correctamente', async ({ page }) => {
  await page.goto('/login')
  await page.getByLabel('Usuario').fill('[email protected]')
  await page.getByLabel('Contraseña').fill('secreto')
  await page.getByRole('button', { name: 'Entrar' }).click()

  // Los selectores por rol sobreviven a cambios de maquetado.
  await expect(page.getByRole('heading')).toHaveText('Panel')
})
Fíjense en el detalle que más impacta en el día a día: en Selenium la espera es responsabilidad tuya. En los otros dos viene de fábrica. Esa sola diferencia explica buena parte de los tests inestables que se ven en proyectos con Selenium mal armado.
Cuándo elegir cada uno
Selenium si:
- Tu equipo trabaja en Java, C# o Ruby y no vas a migrar a JS
- Necesitás cubrir navegadores fuera de los tres grandes, o versiones viejas
- Ya tenés infraestructura de Grid montada y funcionando
- Vas a compartir base con automatización mobile: Appium se construye sobre WebDriver
Cypress si:
- El equipo es de frontend y vive en JS/TS
- La prioridad es que la gente escriba tests rápido y sin fricción
- Querés testing de componentes junto con el end-to-end, en la misma herramienta
- Tu app no depende de múltiples pestañas ni de saltar entre dominios
Playwright si:
- Arrancás un proyecto desde cero hoy
- Necesitás Safari/WebKit de verdad, no una aproximación
- El paralelismo importa y no querés pagar por él
- Tenés escenarios complejos: varias pestañas, varios orígenes, interceptar red
Cosas que no suelen aparecer en las comparativas
La herramienta no arregla una mala estrategia. Un test suite lento y frágil en Selenium va a seguir siendo lento y frágil en Playwright si el problema son los selectores acoplados al DOM, la falta de datos de prueba controlados o testear por la interfaz cosas que se testean mejor por API.
El costo de migrar es real. Cambiar de framework no es solo reescribir tests: es reescribir helpers, fixtures, integración con CI, reportes y la costumbre del equipo. Si lo que tenés funciona, la pregunta no es "cuál es mejor" sino "qué problema concreto me está costando plata".
La brecha se está achicando. WebDriver BiDi es el estándar que busca darle a Selenium las capacidades bidireccionales que hoy son ventaja de Playwright. En un par de años varias de estas diferencias van a pesar menos.
El mejor selector es el que no depende del CSS. Independientemente del framework: roles de accesibilidad, etiquetas y atributos dedicados de test envejecen mucho mejor que una cadena de clases.
Cierre
Si tuviera que resumirlo en una línea: Playwright es la opción por defecto para proyectos nuevos, Cypress gana cuando la prioridad es que el equipo de frontend adopte testing sin resistencia, y Selenium sigue siendo imbatible en diversidad de lenguajes, navegadores y escenarios corporativos.
¿Ustedes qué están usando? Me interesa especialmente escuchar casos de migración: qué los empujó a cambiar y si valió la pena. Y si están arrancando y no saben por dónde, cuenten el contexto (lenguaje del equipo, tipo de app, si hay CI) y vemos entre todos.
Artículo elaborado con asistencia de IA y revisado antes de publicar.
#100
Dudas y pedidos generales / Re:Mother Gigabyte Dejo De lee...
Último mensaje por AXCESS - Septiembre 11, 2026, 10:25:14 PMPocas opciones:
Actualizar BIOS (por si el modelo no fuese soportado o compatible con el motherboard) declara que lo estaba usando pero misteriosos son los caminos...
y...
Llevarselo a un profesional para que lo diagnostique. Recordar que las roturas existen y por ello las fabricas: puede ser que el chipset controlador en el motherboard se haya estropeado, u otro aspecto. Hay que tener experiencia en detectarlo y acceso fisico al dispositivo.
Mi recomendacion: inprovisaciones suelen salir costosas ; recurra a un taller y tecnico de experiencia. No se aventure en experimentos.
Suerte